AIエージェントを中心に4月の個人的な論文まとめ
こんにちは!太田です。 Weekly AI Agents News!の更新を一年続けて、アウトプットの大切さを学びつつ、やっぱり自分で言語化することで得られる養分がある気がしたので、今度はブログを書きました。 技術向けの記事かつ自分のメモ的な感じなので、ほとんどの人には意味がわからないと思います。伝わる人にだけ伝わればいいなという気分です。
個人コメントにその時々で、なんとなく思ったことをつらつらと書いてみました。
忙しい人向けにざっくり自分の興味ある領域って、こんな感じで見えています。
推論時コンピューティング
- 複数の推論パスの探索・比較重視:LRMの登場で、一度の出力に頼らず、複数案を並列・逐次で生成する方法が再加熱
- 検証器(Verifier)の重要度:外部モデルによる正誤判定やペア比較を介し、探索した解を反復的にアップデートする「生成×検証」ループが多く、精度向上の鍵に。
- 効率と精度のバランス:短く、低コストな探索で高精度を狙う動きが強まり、長い推論だけではなく「必要最小限の処理で正答を得る」工夫が注目されている。
エージェントの自己経験の活用
- 経験の構造化と再利用:対話履歴や行動履歴から有用な「事実」「スキル」「プログラム」を抽出・蓄積し、次回以降のタスクに迅速流用する仕組みが増える。
- 失敗の経験の有効活用:AIエージェントの失敗の経験は捨てずにどう活かせるか考える仕組みが増えている。
- 自己探索を重視:エージェントが学習データを収集し、GRPOなどの強化学習で方策を更新する「自己探索による改善ループ」が広がりつつある。
メタエージェント
- クエリ単位のワークフロー最適化:汎用的ワークフローではなく、1問い合わせごとに最適な処理パイプラインを設計・改良する方向が登場した
- メタ報酬モデルによる評価ルールの自己獲得:段階的に報酬モデルとしての評価プロンプトを改善していく手法が登場した。
- エージェントの経験の分析:メタエージェントがエージェントをどう改良するかはエージェントの経験を分析する能力に依存しており、アイデアが出てきている。
AIエージェントへの強化学習応用
- 多目的報酬最適化:正答率だけでなく、ツール呼び出し効率や多様性、探索深度などを組み合わせた総合報酬設計でエージェント行動を誘導。
- 報酬の効果分析:報酬設計がどのような効果を生み出しているのか分析する傾向がある。
AIエージェントの社会実装
- ルーターエージェントによる動的振り分け:入力意図に応じて軽量モデル⇔高性能モデルや専門エージェントを切り替えるハイブリッド構成が定番化
- 特定の業務に対する実環境との接続強化:ブラウザやGUI操作、API連携を通じて現実の特定業務に即した工夫がアルゴリズムに出始めている
- プロンプト以外の工夫が充実:システム側やアルゴリズム側を強化して性能向上に出ているため、動きが遅いと開発力でつけられた差が埋められなくなる
- 推論時コンピューティング
- "Inference-Time Scaling for Complex Tasks: Where We Stand and What Lies Ahead"[paper]
- "Review, Refine, Repeat: Understanding Iterative Decoding of AI Agents with Dynamic Evaluation and Selection"[paper]
- "Dual Engines of Thoughts: A Depth-Breadth Integration Framework for Open-Ended Analysis"[paper]
- "Think Deep, Think Fast: Investigating Efficiency of Verifier-free Inference-time-scaling Methods" [paper]
- エージェントの自己経験の活用
- "Welcome to the Era of Experience" [paper]
- "Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory" [paper]
- "Local Prompt Optimization" [paper]
- "Revisiting Prompt Optimization with Large Reasoning Models—A Case Study on Event Extraction" [paper]
- "Exploring Expert Failures Improves LLM Agent Tuning" [paper]
- "Inducing Programmatic Skills for Agentic Tasks" [paper]
- "AGENTADA: Skill-Adaptive Data Analytics for Tailored Insight Discovery"[paper]
- "SkillWeaver: Web Agents can Self-Improve by Discovering and Honing Skills"[paper]
- "Iterative Trajectory Exploration for Multimodal Agents" [papaer]
- メタエージェント
- AIエージェントへの強化学習応用
- AIエージェントの社会実装
- "Toward Super Agent System with Hybrid AI Router" [paper]
- "The AI Scientist-v2: Workshop-Level Automated Scientific Discovery via Agentic Tree Search" [paper]
- "UFO2: The Desktop AgentOS" [paper]
- "AgentA/B: Automated and Scalable Web A/B Testing with Interactive LLM Agents" [paper]
- "UXAgent: A System for Simulating Usability Testing of Web Design with LLM Agents" [paper]
- 評価データセット作成
- サーベイ論文
- 📖 "Meta-Thinking in LLMs via Multi-Agent Reinforcement Learning: A Survey" [paper]
- 📖 "A Survey of Frontiers in LLM Reasoning: Inference Scaling, Learning to Reason, and Agentic Systems" [paper]
- 📖 "Challenges and Paths Towards AI for Software Engineering"[paper]
- 📖 "A Survey of AI Agent Protocols" [paper]
- 📖 "Advances and Challenges in Foundation Agents: From Brain-Inspired Intelligence to Evolutionary, Collaborative, and Safe Systems"[paper]
- 📖 "Adaptive Human-Agent Teaming: A Review of Empirical Studies from the Process Dynamics Perspective" [paper]
- 最後に
推論時コンピューティング
"Inference-Time Scaling for Complex Tasks: Where We Stand and What Lies Ahead"[paper]
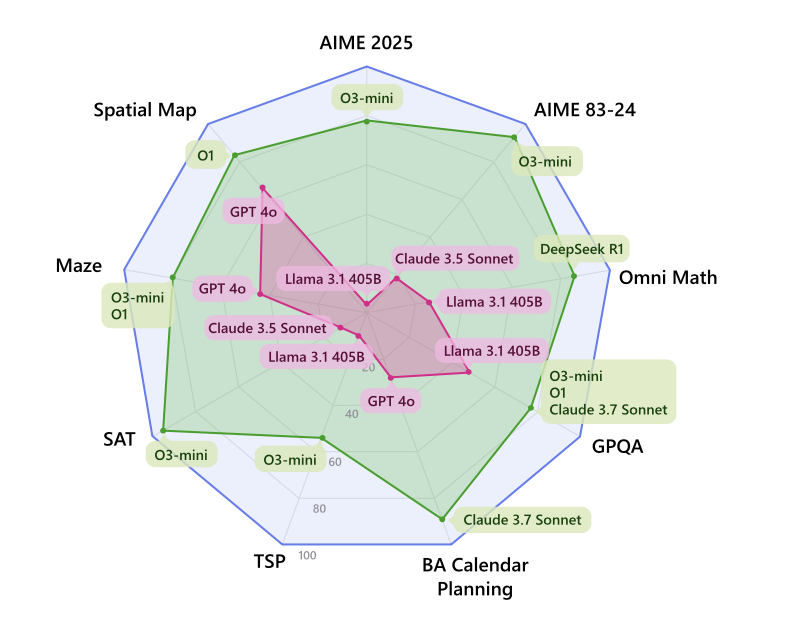
Microsoft がLLMだけでなく、LRMに対してもInference-Time Scaling によって、どのように複雑な問題に対する推論能力を向上できるかを評価・分析。
手法の比較は3つで、CoT、Parallel Scaling(解探索空間が広く、複数案を試したいときに用いる)、Sequential Scaling(フィードバックを与えれば改善できそうなときに用いる)。モデルは図を参照。
わかったこと
- 推論スケーリングは有効だが、難問だとトークン数を消費しても効果が限定的
- 長い出力ほど精度が高いわけではなく、むしろモデルが苦戦している兆候である
- 正答率が常に100%のケースですら、毎回異なるトークン数でばらつきが見られる
- 正解を知る検証器を用いることで精度は向上するため、汎用的・高精度なVerifierの開発が鍵
- 通常モデルのGPT-4oに対し、簡単な問題なら最大256回の呼び出し + aggregationを行うことで、O1と同等の精度に近づける
- タスクにより、ParallelとSequentialの効果が異なる
| シナリオ | 最適なスケーリング戦略 |
|---|---|
| カスタマーサポートのFAQ応答 | CoTだけで高速応答 |
| 複雑な科学的問題解決(GPQAのようなタスク) | Parallel Scalingで幅広い解答探索 |
| 複数制約下でのスケジュール調整(BA-Calendar) | Sequential Scalingで修正と再提案 |
| NP困難問題(TSP, 3SAT) | Parallel探索+Sequentialで自己修正強化 |
個人コメント
- LRMにも推論スケーリング手法は有効なときがあり、その手法の使い分けは問題の性質ごとに異なる
- 検証器の性能向上は人間の代替に不可欠で今後も研究されていく
- 最近は「長い推論を行えば精度も向上する」件は否定され気味で、「短くても正しい」推論パスを探索する能力が求められている
"Review, Refine, Repeat: Understanding Iterative Decoding of AI Agents with Dynamic Evaluation and Selection"[paper]
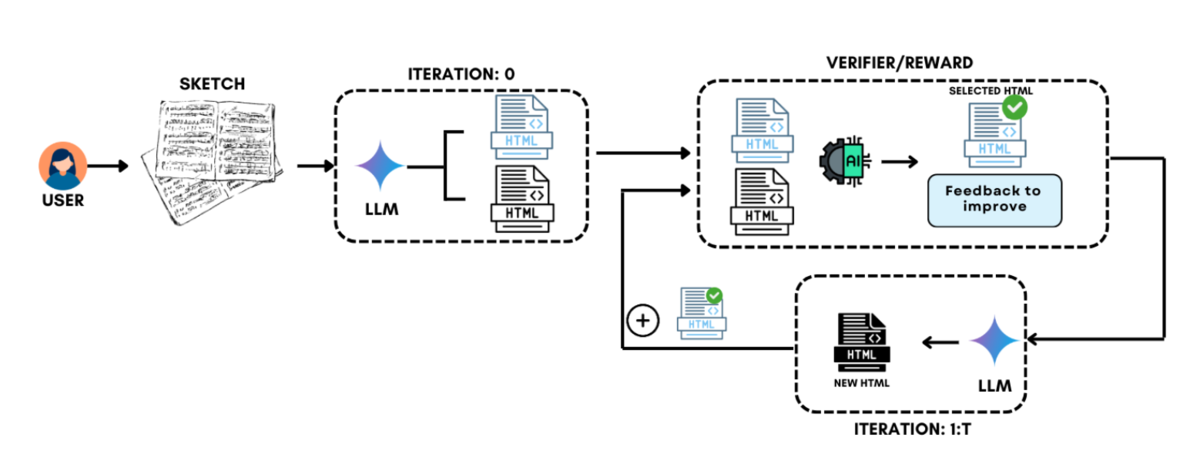
Googleらが推論時(inference-time)においてAIエージェントの出力を反復的に評価・改善する手法を提案。 アルゴリズムはシンプルで、最初は二つの回答を用意し、外部の検証器(verifier)によるペア比較を行う。良い方の応答を改善して、改善前と改善後でまたペア比較する。これをT回繰り返す。 Sketch2CodeやText2SQLで3~4%の改善につながった。
個人コメント
- 昨年や一昨年にあってもおかしくない手法だけど当時はなかったのか
- 生成の質を高めていきたいときに使うのが良さそうだが、どんな方向に生成結果を発展させるのか制御するのが難しい印象
- 検証器の役割が重要で、何を持って良いとする信念があるのか、次の改善施策は何を提示したのか、検証器の生成内容を系列で分析する必要がある
"Dual Engines of Thoughts: A Depth-Breadth Integration Framework for Open-Ended Analysis"[paper]
単一の正解がなく、多次元的、多面的な分析を要したり、戦略を考えるような質問応答やレポーティングタスクは回答に深さと広がりが求められる。 NeuroWatt社がプロンプトのワークフロー形式で回答に深さと広がりを出すDual Engines of Thoughts(DEoT)を提案。
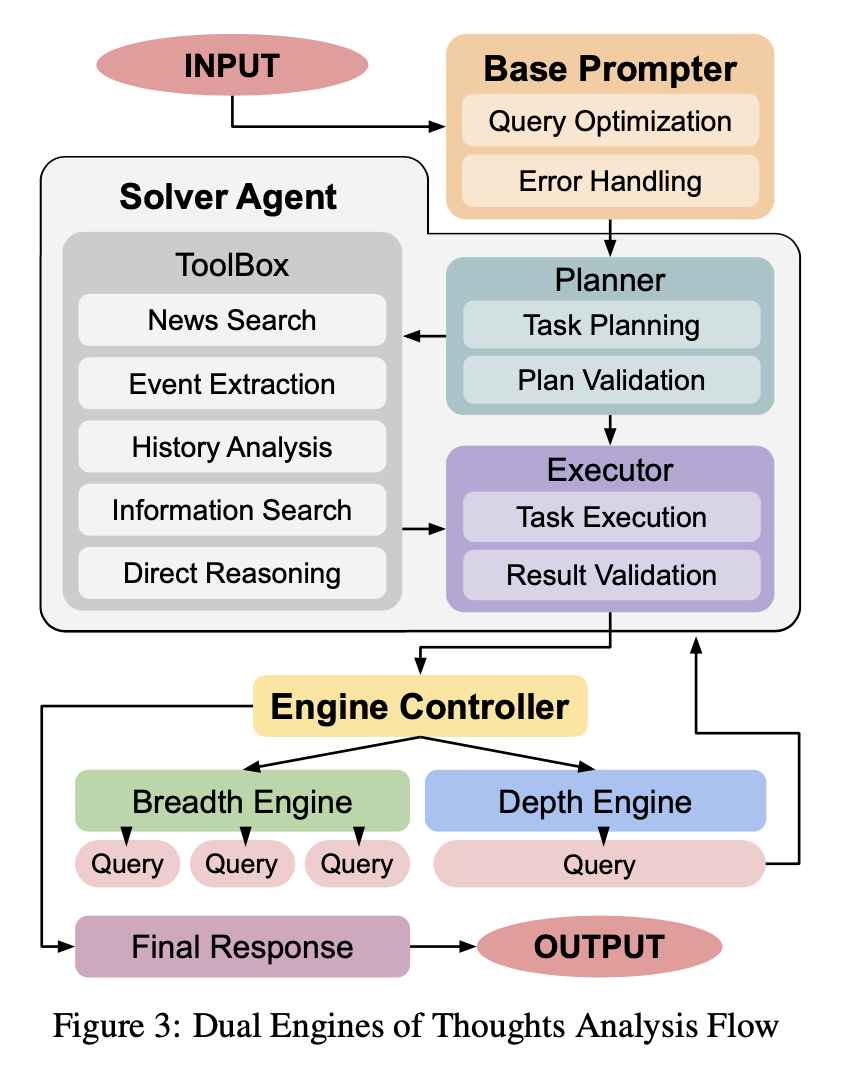
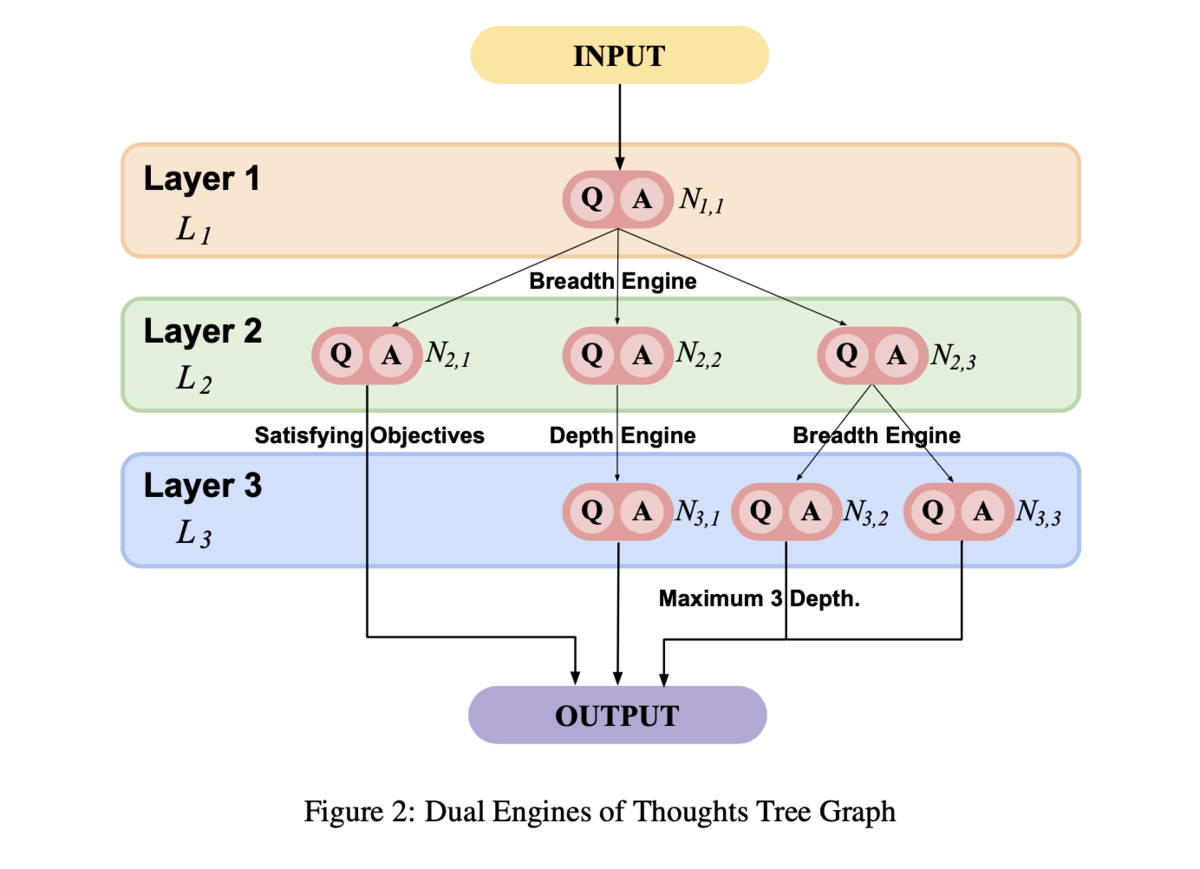
処理の流れはユーザークエリの洗練で、あいまいさの除去、用語の標準化、時間コンテキストの付与などを行い、分析用に最適化されたクエリに変換。次にタスク実行を行い一次回答を作成。 そこから評価器が「Breadth(広範探索)」と「Depth(深掘り)」のどちらを次に実行すべきかを決定する。 判断基準として、内容の複雑さ(Content Complexity)、進捗状況(Progress Metrics)、未解決の論点(Unresolved Points)などを考慮する。その後、深さか広さかに応じてクエリを生成して回答に厚みを作り、最大3回まで繰り返す。
個人コメント
- シンプルながらリスク評価、法規制、危機管理、戦略など様々な側面で考える必要があるケースに有効な技術に思う
- 人間からのクエリだけクエリ最適化を入れたあたり人間に対する期待が伺える
- プロンプトや実際の挙動がAppendixにあり参考になる
"Think Deep, Think Fast: Investigating Efficiency of Verifier-free Inference-time-scaling Methods" [paper]
外部報酬モデル(検証器)を必要としないな推論時スケーリング手法を、LRMとLLMの両者において系統的に比較し、その計算効率と性能のトレードオフを明らかにした。 LLMには、Llama-3.3-70B-Instruct, Qwen2.5-72B-Instruct, GPT-4o-mini、LRMには、Deepseek-R1-Distill系列、QwQ-32B-Preview などを用いる。 検証器不要な推論時スケーリング手法として、以下を用いる。
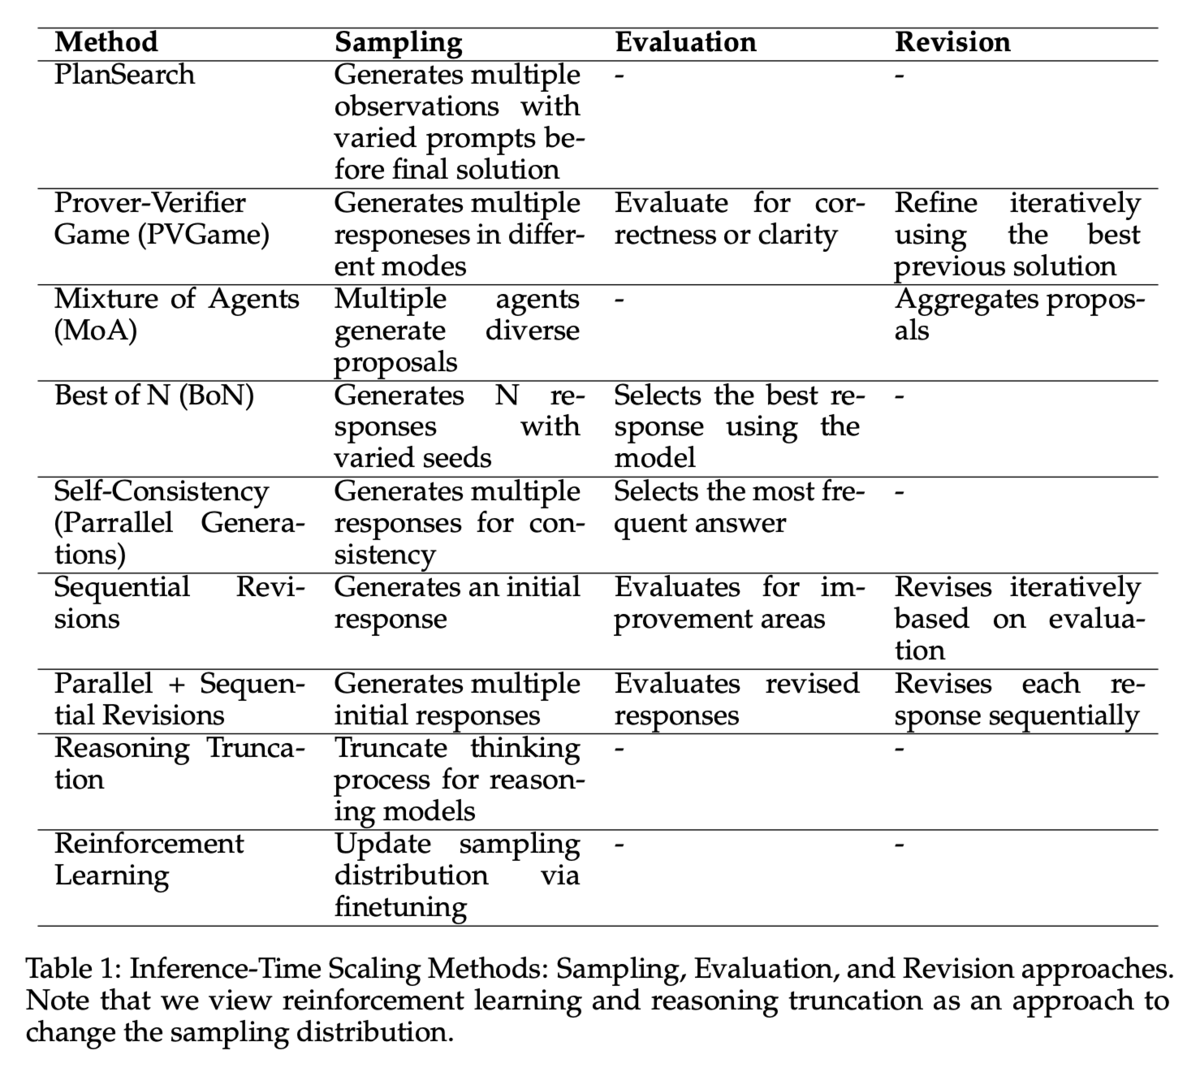
- 非推論モデル vs. 推論特化モデルでは、通常のLLMにいくら推論時スケーリング手法を適用しても推論モデルに精度が届かない結果になった。また通常のLLMに推論時にトークンを消費し続けさせると精度が向上することもあるが横ばいが多い。
- 推論モデルに検証器不要(verifier-free)手法を適応しても精度が改善されなかった。これは、推論モデルが訓練段階ですでに高度な思考能力を獲得しているため、追加の検証器や報酬モデルなしに推論時だけ強化しても伸びしろが小さいことを示唆する。
- テスト時推論スケーリング手法のうち、多数決は効果があるが、内省して誤りがあれば直すsequential_revisionsは精度がどれでも悪化したり、横ばいで改善はしていない。
- LLMは応答長が長くても短くても精度に影響は小さい。LRMは短い方が正答率が高い結果になった。

個人コメント
- 検証器なしでお気持ちで精度よ高まれ理論はきつい気がする。業務的には目的を満たしたかの検証器を入れることが多い。
- 多数決手法(シード値を変えるだけ)はどの時代も安定して性能向上につながっている。
エージェントの自己経験の活用
"Welcome to the Era of Experience" [paper]
David SilverさんとRichard S. Suttonさんが今後のAIの方向性についてエッセイを書いた。
従来の「人間データの時代」を超え、エージェントが自身の経験から学ぶ「経験の時代」への移行を論じている。
なぜ今なのか。今までのRL はシミュレーションに限定されていたが、最近はLLMのAPI操作やGUI操作により、デジタル世界とのインタラクションの敷居が下がったことが要因。

個人コメント
- 環境とのインタラクションで膨大な経験を溜められる業務がどの程度あるか
- 経験の是非を評価する報酬設計が難しい
"Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory" [paper]
対話型AIシステム向けに設計されたMem0 はメモリ管理機能。LLMのロングコンテキスト問題に対処する方法で、対話履歴から事実を抽出し、DBの事実情報を更新する。会話履歴も定期的に要約を行い、数十ターンの会話履歴を圧縮していく。 そうすることで、ユーザーと会話するときは、LLMのプロンプトに渡す情報が圧縮できる。(会話の全体要約、直近の対話と事実)
会話から抽出される事実の例として、日時・場所:「次回レビュー会議は6月3日10時から」「東京本社ビル3階」 進捗・数値:「テスト完了率は85%」「残タスク数は12件」 責任者・関係:「山田さんがドキュメント作成を担当」「B社との契約交渉が開始済み」 状態変化:「設計フェーズが完了した」「リリースが延期決定」が挙げられる。

実験では長い文脈で様々なタイプの質問応答で比較。RAGやフルコンテキスト、Mem0で精度を比較すると、Full-Context が最も高い精度(72.9 %)を示すが、約26 000トークンすべてを毎回投げるため、実運用時のレイテンシやコストが非常に大きい点がネック。 RAG は分割チャンク(128トークン)を使う手法で、メモリ消費とレイテンシは抑えられるものの、精度は47.8 %と大きく劣る。 Mem0 は「動的ファクト抽出&更新」によって重要情報だけを保持し、66.9 %という高い精度を維持しつつ、Full-Context比で約92 %のレイテンシ削減を実現している。
個人コメント
- フルコンテキストの方が精度高いこともあるのか。同一会話の文脈であればそうか。別の経験をICLで使うのとは違うのでそりゃそうか。
- Mem0はOSSとして公開されていたのがついに精度検証した論文を公開した形。
- メモリって汎用的な設計はできず、基本的に泥臭くプロジェクト単位で仕組みを作るものだと思っている。これは会話用のメモリ設計の例。抽出すべき事実もコンテキストに応じて色々ありそうな。
"Local Prompt Optimization" [paper]
Microsoftからプロンプト最適化のテクニック的な研究。 プロンプト全体を最適化するのではなく、部分的にeditタグをつけた領域だけ最適化することを提案。 探索空間を狭めて、有名どころの手法で評価した結果、必要な最適化ステップが減少し、精度も2~5%程度は改善する結果になった。


個人コメント
- editタグで囲むのが文全体とか段落でなく、5単語以内という制約がかなり謎。経験的にその単語数くらいが良いらしい。
- 実験結果を見ても、元からグローバルな最適化ステップ数が4とか2.5で少ないのでそれが半分になっても嬉しさが分かりにくい。各ステップで数時間かかるならインパクトは大きく見える。
- 単純にプロンプトの変えたくないところはあるので、変えたい部分だけ最適化するというならば、そのアイデアは面白いなと思った。
"Revisiting Prompt Optimization with Large Reasoning Models—A Case Study on Event Extraction" [paper]
LRMのプロンプト最適化の有用性を評価。LRMでプロンプト最適化の意味があるのかが問い。タスクは構造化タスクであるイベント抽出。 MCTSでプロンプトを最適化している。 最適化されたプロンプトによって、イベント抽出精度が10%~20%程度向上している。 特にプロンプトが変更された箇所は細かい粒度な抽出ルールの追加、例外対応、プロンプトの構造化と簡素化に分類される。 MCTSベースの最適化ループでは、モデル出力の誤りを解析し、フィードバックをもとにプロンプトを逐次更新する。 このプロセスは、LRMが事前学習でカバーしきれないタスク固有の知見やコーパス依存のノイズを吸収し、モデルの一般化性能を引き上げる役割を果たす。
個人コメント
- 人間でもプロンプトにルールを追加できるが限界がある。同様に例外処理を全てプロンプトに記述するのは困難。その辺を自動で抽出しプロンプト(メモリ)に貯めるのは嬉しい場面がある。
- タスクの裾野の広い部分をエージェントが自動で経験を溜めて、頑健性を高める方向性は有用かもしれない
"Exploring Expert Failures Improves LLM Agent Tuning" [paper]
UCLAやOpenAIらがWebナビゲーションを題材に難しいタスクの失敗の軌跡を有効活用したエージェントの学習方法(自己探索を組み合わせたファインチューニング)を提案。 先行研究のRejection Sampling FTは、専門家(GPT-4など)の成功例とモデル自身が環境を探索し、新たに見つけた成功軌跡を繰り返し教師データに追加し fine‑tune する。
提案するExploring Expert Failures(EEF) は、Rejection Sampling FTの拡張で、専門家の失敗軌跡に着目する。 専門家が失敗した軌跡のうち、どの途中状態からなら学習中のエージェントが解けるかシミュレーションする。
シミュレーションが成功から失敗に転じる初めての状態(回復が必要な状態)をrecovery state と定め、そこから成功した自己探索軌跡だけを学習に取り込む。 要するにEEF では専門家の失敗軌跡のうち「どの状態でモデルがつまづくか」を細かく検出し、つまづく状態から回復した軌跡を学習することで、効率的に難問なサブタスクを克服していく。
実験では、回復が必要な状態として検出された地点のうち、少なくとも10%前後は後続の自己探索で成功例が得られ、成功に繋がったらしい。
個人コメント
- 最初読んだとき、専門家モデルで解けないタスクがなぜ学習途中のエージェントの分際で専門家モデルの軌跡の途中からなら解けるようになるのか不思議だった。専門家モデルが確率的に行動を間違えたことが原因によるものなら、まあ学習途中のエージェントが解けても納得はする。どうやら専門家モデルは汎用的なモデルで、Webサイトのドメイン知識がなく解けないことがあるとのこと。学習エージェントは簡単なタスクの軌跡を学びながら少しずつドメインを知り、難しいタスクの進捗率を徐々に高めるらしい。要するに専門家モデルのドメイン知識不足による失敗を集中的に解決していくことで精度の向上を目論んでいる。
- エージェントの軌跡を「実験的知見に基づくヒューリスティック」な設計で泥臭く取り組んでいるように感じた。
"Inducing Programmatic Skills for Agentic Tasks" [paper]
CMUからオンラインでAIエージェントのスキル獲得を目指すASI手法の提案。 スキルは特定の目的のために複数の行動を組み合わせた一連の手続き。 オフラインで軌跡データからスキルを学習すると実際のタスクと合わないことがある。 そこで「プログラムとして表現可能かつ実行を通じて自動検証できるスキル」をオンラインで蓄積し、エージェントの行動空間へ直接組み込む。
最終的に安定性があり、効率的なウェブナビゲーションを実現することを目的としている。 スキルの更新タイミングはタスクのエピソード終了時で、正しく完了できたかをフィルタリングする。毎タスク終了時に走ることを再強調しておく。 問題なければ、一連の処理をまとめたプログラム(スキル)を生成し、既存の正解軌跡とスワッピングし、スキルの検証を行う。

スキルの例
def open_marketing_reviews():
    """マーケティングメニューの「All Reviews」セクションを開く。

    Args:
        None

    Returns:
        None

    Examples:
        open_marketing_reviews()
    """
    click("Marketing")
    click("All Reviews")
WebArena ベンチマークで、平均ステップ数を10%程度の削減、タスク成功確率の向上(ASI: 40.4% Vanilla: 16.9%, AWM: 35.5%)を達成した。 ロングステップタスクにおいても、ASI が Vanilla 比で平均38.9%、AWM 比で平均20.7%という大幅な成功率向上。
応用的観点でコメント
- GUIを操作するタスクではどうしても一つ一つ実行してLLMに確認させていると遅すぎるが、まとめて関数化しておくことで処理を高速化できる良さがある。
- スキルの管理は必要になる。すぐにスキルが数百に達するため、共通部分は削除するか統合するか検索するか必要になっていく。
- エージェントのスキルの利用回数を分析すれば、どのタスクが多く頻繁に行われるか分かるようになるのは業務の透明性が上がると思った。
- さらに失敗したタスクはスキルに記録していないが、失敗したタスクこそ、人間がスキルを作ることで成功率がさらに高まると思う。
- スキルをバッチで作るか、逐次で作るかは議論あり。
- 研究としてスキル作成は去年からあるが、オンラインで作る部分に新規性を感じた。
"AGENTADA: Skill-Adaptive Data Analytics for Tailored Insight Discovery"[paper]
ユーザの目的・ペルソナに応じて最適な分析スキルを自動選択し、深いインサイトを抽出するためのエージェント(AGENTADA)を提案。
AGENTADAの基本的な流れは、データ理解に必要な基礎的質問を生成し、その後より高度な分析のための発展的質問を生成する。 そして事前に用意したスキルライブラリ(分析手法の実装と要約)をもとに質問の意図に応じてスキルを選択する。 その後、データと質問、スキル内容をもとに自己修正しながら実装し、分析結果をもとに回答する。 最後は全ての質問に対する回答が揃えば「今後何をすべきか」まで踏み込んだインサイトを提示する。
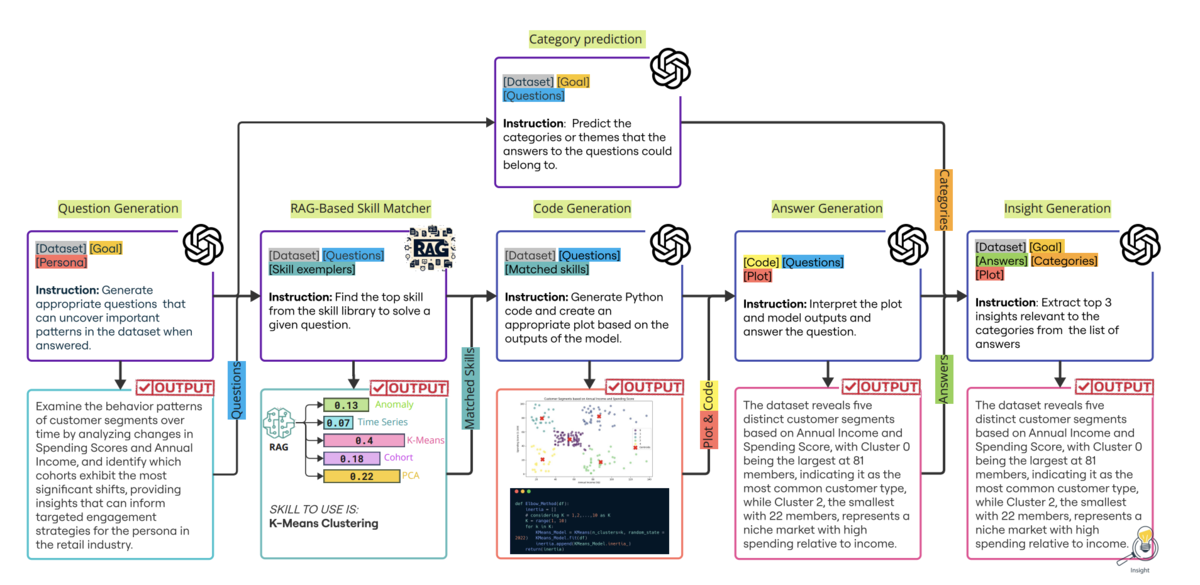
個人コメント
- スキルを事前に用意することで分析の質を高めるのは主流なアイデアであるものの、人間の経験と知見をエージェントに託すのはビジネス的にも差別化になる大事な部分。
- 事前に人間がスキルを用意してあるが、そのうちエージェントが人間のスキルなどを見ながら新たなスキルを作るのは容易に想像できる。
- それよりもこの手法は評価が人間では困難になることを考え、LLM as a Judge を採用し、評価用のシステムプロンプトをプロンプト最適化している。
- 最終的にペア比較のプロンプトで、評価基準6つに対してどちらが優れているか、同等か、どちらも微妙かを選ばせ、深いインサイトが抽出できているか判定している。
"SkillWeaver: Web Agents can Self-Improve by Discovering and Honing Skills"[paper]
エージェント自身がWeb環境を探索しながら再利用可能な「スキル」を API として自動生成・精錬するフレームワークを提案。 SkillWeaver は3段階のパイプラインになっている。
- 環境探索 初期エージェント(CodeAct) がWebサイトを探索し、スクショやアクセシビリティツリー等を収集
- スキル提案 環境探索で得た情報から短期完結かつ汎用性の高い操作(手続き、ナビゲーション、情報探索)を候補として提案
- スキル合成 提案されたスキルを Playwright コードで繰り返し実行し、成功した操作軌跡を LLM によって Python 関数として生成
- スキル精錬 自動生成した API に対し、LLM がテストケースを生成して単体テストを実行し、失敗時はデバッグして信頼性を向上
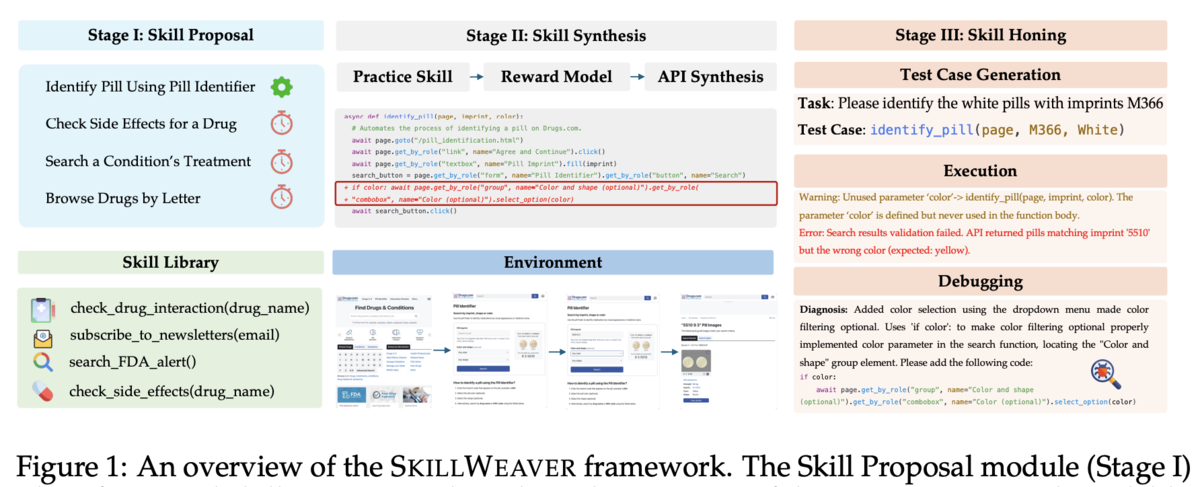
提案されるスキルの例(実験では各環境で160個のスキルを提案している)
identify_pill(page, imprint, color=None, shape=None)
- Drugs.com のピル識別ページを操作し、刻印や色・形状でピルを検索する機能
apply_multiple_filters(page, make, model, distance, zip_code, max_price)
- Cars.com で車種(make/model)、距離、郵便番号、価格上限など複数条件を組み合わせて検索結果を絞り込み
search_FDA_alert(page)
- 最新の FDA アラート情報ページへ遷移し、緊急安全性情報やリコール情報を表示
check_side_effects(page, drug_name)
- 指定薬剤の副作用(Side Effects)ページを開き、詳細な副作用情報をスクレイピング
実サイト評価(Online-Mind2Web 上の4 サイト、計57 タスク)でも、成功率が40.2→56.2%に向上した。
個人コメント
- タスクの処理の中で意思決定が入らない場合はどんどんスキル化しておくのが良さそう。
- スキルの呼び出された数などに応じて、不要なものは削除していく管理もありそう。
- サービスとして、最初に顧客環境を探索させ、顧客環境ごとにスキルを作らせておくとGUI操作のエージェントも民主化が進むか。
- 自己改善の研究には、パラメトリックとノンパラメトリックがある。パラメトリックは探索軌跡を使ったファインチューニングや強化学習、ノンパラメトリックは再利用可能なワークフローやメモリ、APIを作る方針。
"Iterative Trajectory Exploration for Multimodal Agents" [papaer]
マルチモーダルエージェントが新たな環境に適応する際、必要な専門的アノテーションなしで自己探索的に学習する枠組みを提案。 SPORT(Step-wise Preference Optimization for mulTimodal aGents)はエージェント自身がタスクを合成し、各ステップごとに候補解を生成・検証し、その結果に基づくステップ単位の「好ましい」/「非好ましい」ペアデータを用いて方策を更新する。

手法としては、4ステップで、最初に、既存のシードクエリとツール説明をもとに多様なタスクを生成。 ステップサンプリングでエージェントが複数パターンの1ステップを作成し実行。 検証器がステップレベルで最も妥当な解を選び、それ以外は好ましくないデータとし、選好ペアデータを作成。その後、最も妥当な解をもとに次のステップを探索し、エピソード終了まで続ける。 DPOでオフラインに蓄積された選好データで方策を学習し、その後更新後の方策でサンプル収集を再度行う。

個人コメント
- ツール呼び出し失敗や不適切な候補からも負例を収集し、無駄なくより多くの学習データを獲得している。発想は自己教師の考え方なのかな。失敗軌跡データの有効活用の新たな一手という感じ。より一層、検証器の重要性が増す。
- マルチモーダル業務自動化において、専門家ラベルなしでエージェントが作れるようになるのは嬉しいが、その代わりにタスク合成用の環境や検証器のプロンプトなどを用意する必要がある。
- 正解ペアを用意するのと、タスク合成用の環境を用意するのはどちらが大変かという世界。中長期的にはタスク合成用の環境を作る方がメリットが大きいか。顧客のPoCのたびにタスク合成環境を作るのは煩わしい。世の中的には正解ペアデータを人力で用意する方が多い。
メタエージェント
"FlowReasoner: Reinforcing Query-Level Meta-Agents" [paper]
シンガポールの企業(Sea AI Lab)や大学を中心に研究された個々のユーザークエリに対してエージェントワークフローを生成する研究。 タスクレベルでエージェントを生成する既存のメタエージェントと異なり、個々のクエリレベルと1段階解像度が高いのがポイント。 タスクで一律のワークフローでは“過剰設計”や“過少設計”が生じやすく、性能や効率の最適化が難しい。
メタエージェントの役割は「ユーザークエリを受け取り、サブエージェントをどう組み合わせるかを“思考”し、そのワークフロー(コード)を生成する」こと。
メタエージェントが作るエージェントワークフローは「Code Generator」「Review」「Revise」「Code Test」「Ensemble」「Format Generator」の6種類のオペレータを組み合わせて作る。プロンプトも全て事前定義されている。
メタエージェントが生成するクエリごとのエージェントの例
「指定した時間帯の各車種の交通データをCSVに保存し、折れ線グラフを作成してください」
- CodeGenerator:CSV出力+グラフ生成コードの作成
- CodeTest:テストケース実行による動作検証
- Review:グラフ描画ロジックの評価
- Revise:レビュー結果に基づくコード修正
- FormatGenerator:最終的なレポート出力
「文字列を単語ごとに分割し、その配列を返す関数を実装してください」
- CodeGenerator:初期実装コード生成
- CodeTest:組み込みテストケースでの検証
- Review:失敗したケースの原因分析
- Revise:レビューに基づくコード修正
「与えられた文字列内の単語を逆順に並べ替えて返す関数を実装してください」
- CodeGenerator:複数パターンで候補生成
- Ensemble:生成候補の統合・最良選択
- CodeTest:選択解のテスト検証
- Review/Revise:必要に応じた改善
メタエージェントの学習
メタエージェントとなるLLMは軽量なため、フロンティアモデルで蒸留データを作り、SFTでワークフローの生成の仕方を学び、RLでオンポリシーに報酬最大化するようにワークフローの作り方を学ぶ。 報酬は多目的になっている。お気持ちは、生成したワークフローでのpass@kを向上させ、ワークフローの複雑度を減らし、ワークフローの多様性を増やす方向で最大化する。 蒸留データの軌跡には、メタエージェントの指示分、ユーザークエリと「ワークフロー作成のCoT、ワークフローコード」のTラウンド分が含まれている。 テストケースがあるため、テストが通るまで思考し、ワークフローコードを更新する。
推論時のメタエージェント
FlowReasonerは、10ラウンドまで繰り返して、前ラウンドの結果を踏まえながらエージェントワークフローを生成する。 10ラウンド中の最大の報酬となるエージェントワークフローが成果物となる。報酬の計算をしているので、pass@kを評価していることになる。つまり運用時にも最適なワークフローを得るのにテストデータが必要になる。
このメタエージェントが生成できるエージェントワークフローは、コード生成で実行でき、人間からテストケースが渡せることに制限される。
実験結果では、AutoAgents, ADAS, Aflow, MaASと比較している。
提案手法が一見、既存のメタエージェント手法を凌駕しているように見える。

個人コメント
- アプリケーションとして、質問クエリのたびにテストケースが必要となると利用用途は限定的に思う(テスト作成を自動化できるのも限定的)
- 10ラウンドもエージェントを作成し、その度にpass@kを評価してるのは実行時間も長く実用的でないと思う
- 業務利用する場合は、事前に様々なクエリでエージェントワークフローを無数に作っておき、そこから自動選択する方が良さそうだが果たして。
- ツール利用ができるオペレータや別のDB操作オペレータを導入する場合は、蒸留データセットから用意する必要がある(学習時には存在しないエージェントのため)
- 手法として、テストケースが通るまでコードの自己修正をする手法と何が違うのか。
- 実験の種明かしではないけど、既存研究のメタエージェントと生成されたエージェントで使うモデルは、論文のオリジナルから変えていないのでo1-miniより精度が低いモデルgpt-4やgpt-3.5などが利用されている
"A Self-Improving Coding Agent" [paper]
iGent AI 社は、SICA(Self-Improving Coding Agent)という自己改善をしていくエージェントを提案。 基本的なコーディングツールを備えたエージェントが自己のコードベースを自律的に編集する。
ベースには既にコーディングエージェント、問題解決エージェント、推論エージェントとファイル操作やシェルコマンド実行などのツール群は用意されている。メタエージェントは、効用が最大化するようにコードベースのファイル全てを対象にコード編集する。以下のリポジトリのベースエージェント配下が編集範囲。 github.com
そして変更後のコードベースとベンチマークのスコアをアーカイブとして記録し、次のエージェントの改変に利用する。
効用関数はベンチマークのスコア、実行時間、コストの3要素の重みつき和となる。

自己改変をしていくと、エージェントを増やすことはなく、各種ツールを増やす行動が多いことがわかった。 Quick Overwrite Tool, Diff-Enhanced Smart Editor, Optimized File Edit Routing, Simplified DiffVerifier Testsなど14種類が段階的に追加された。
コード生成にはo3-miniやSonnet-3.5-v2を利用。 実験の結果を見ると、効用は下がったり、上がったり変動を続けながらも上昇傾向にある。過去を振り返りつつ、改善ができている証拠。

個人コメント
- コーディング能力が向上していくと、エージェントやツール群を含む作業ディレクトリ自体を自己改変していくのか
- エージェントが後で読む前提でREADME.md が丁寧にとても長く書かれているので、その辺りがショートカットするポイントなんだと思う
- 1 iter およそ1時間程度かかり、業務で利用するには費用がかさみそう(過去のアーカイブの分析やファイル理解など)
"Toward Evaluative Thinking: Meta Policy Optimization with Evolving Reward Models" [paper]
MIT、Grammarly社とミネソタ大学との共著で、メタ報酬モデルを提案。
RLAIF(Reinforcement Learning with AI Feedback)では評価プロンプトを人間が作っていたが、この作業は校正が難しく、反復的かつ労働集約的で一言で大変だった。
そこで、提案するMPOは、3つのフェーズに分けて実行され、評価プロンプトを作成する。

メタ解析、メタ改良、メタ統合の3フェーズを順番に行う。
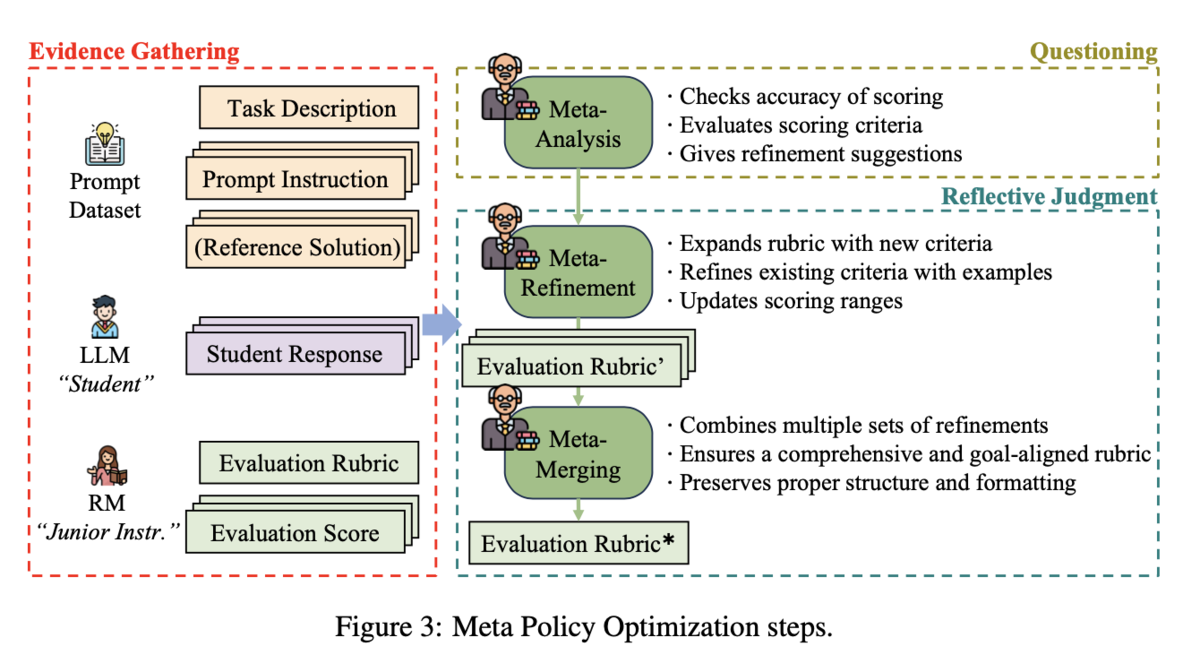
メタ解析 現 RMが見落としている評価不足点や、報酬ハッキングになっている例を検出し、入力について、どの評価項目を「追加/分割/修正」すべきかを具体的に挙げる。 メタ解析のモジュールには入力に、バッチ単位でタスクのプロンプトとLLMの回答とそれに対する現行RM のスコアと評価プロンプトが与えられる。LLMにはバッチから一件ずつ渡して処理する。要するに一件ずつ具体的に内容を見て、後で統合するスタイル。
メタ改良 Meta-Analysis で得られた改良案リストを入力として受け取り、より構造化かつ定量化により、評価プロンプトに組み込める用に改良していく。 まずは改良案の一つずつを「点数加算用」「減点用」「調整用」に分類する。理由は各改良案が「評価対象の良い行動を増やす」「評価対象の悪い行動を抑える」「評価の点数配分を整える」のどれなのかを明確にするため。 その後、各改良案を加算用や減点用の場合、評価目的、スコア、その基準、その例を生成する。評価がブレないようにするため。
メタ統合 n 件分の改良済ルーブリック案(評価の基準と尺度をまとめた表) を一つの統一的かつ整合性のあるルーブリックに統合する。 ここでは一度の呼び出しで一気にまとめる。バッチサイズが大きいと最後の統合でコンテキスト長から溢れるリスクあり。
実験ではバッチサイズを64にし、MPOは、10や20バッチごとに一度走らせている。 様々なタスクで検証しているが、思想は良いメタ報酬モデルは良い報酬モデルを作り、その報酬モデルを使うことで学習対象のLLMがそのタスクで性能向上することを示す。 また、MPOが生成する報酬モデルのプロンプトのトークン数の遷移と評価データにおける報酬モデルのスコアを確認している。
実験の結果的には精度は数%程度の改善に留まるが、効果はある。評価プロンプトのトークン数の遷移も最初に一気に増え、横ばいになる。無闇に増やし続けることはなさそう。 また、報酬モデルの平均スコアはプロンプト更新されていくと評価が厳格化して下がっていることが分かる。 RM と MRM のモデルサイズが異なると、語彙や推論深度のミスマッチで改良案が RM にうまく伝わらず性能低下を招く傾向があるそう。

個人コメント
- メタ報酬モデルの考え方は応用が効くし、様々な方法が思いつく一方で、その効果が有効な領域を知っておきたい。
- 評価の曖昧性や多様性 が高いほど、MRMが新たな観点を自動追加する価値が大きい。一方で、評価が二値判定で十分なタスクでは、固定モデルの簡潔なスコアリングで済み、MRMの反復改良は過剰になる。
- コンテキストと処理の重たさを意識して、更新頻度とバッチサイズは細かく決めていそう。
AIエージェントへの強化学習応用
"OTC: Optimal Tool Calls via Reinforcement Learning" [paper]
LLMの推論中に、外部ツールを呼び出すTool‐Integrated Reasoning の学習が注目を集めている。 提案手法はツール呼び出し回数を抑えつつ、回答精度を落とさない報酬設計を行なった。
その結果、ツール呼び出し回数を大幅に削減しながら(最大73.1%減)、回答正答率をほぼ維持した。
実装は既存の PPO/GRPO パイプラインに数行の差分を加えるだけ。報酬を「正答性×ツール効率」という単一スカラーにすると、過剰呼び出しも未呼び出しも抑制。
個人コメント
- 報酬設計の重要さがよく分かる研究
- シンプルながらインパクトの大きい結果が得られている
"ToolRL: Reward is All Tool Learning Needs" [paper]
LLMの推論中に、外部ツールを呼び出すTool‐Integrated Reasoning の学習における報酬の効果を分析した研究。
基本の報酬設計は、フォーマット報酬と正確性報酬の足し合せ。
フォーマット報酬 (R ∈ {0,1}) は、モデル出力に
学習条件(SFT, RL)を様々変えて比較検証している。 結果、SFTしなくてもフォーマット報酬を入れているから直接RLした方が精度が出ている。 フォーマット報酬を除くなら、おそらくSFTしないと学習が不安定になると思う。 PPOとの比較では、GRPOが安定的かつ高い性能向上を示した。

アブレーション分析
- 思考長さ報酬は必ずしも有効ではない
長い think セグメントを奨励する「長さ報酬」は、確かに思考トレースを延長するものの、多くのベンチマークで性能向上に寄与せず、小規模モデルでは逆に大幅な性能低下を招くことが明らかになった。長く喋らせること自体に意味はない。
- 報酬スケールは滑らかな動的調整が鍵
最初はフォーマット報酬に重きを置き、中盤からツールの扱い方を理解するのを重視するように、報酬のウェイトを学習ステップ数で滑らかに調整すると、学習の安定性と汎化性能が最も改善されることが確認されました。非常に直感的。
- 報酬分解が学習を促進する
ツール名・パラメータ名・パラメータ値を個別評価する設計は、3要素の完全一致にのみ報酬を与える設計に比べ、学習時の報酬獲得が「より多く・より細かく」得られ、最終的なタスク性能も高いことが示された。階段を登るように最初はツール名が合うだけでも報酬を貰え、徐々に学習でき安定する。
個人コメント
- 報酬設計は興味深いので好き。いろんな報酬で何が上手くいったのか、ダメだったのかこれから色々と公開されそう。
- ツール利用を獲得する事後学習とは別に、推論時にツールの適切な利用方法を学ぶ研究が増えている。Deep Researchの影響か。
"LLMs are Greedy Agents: Effects of RL Fine-tuning on Decision-Making Abilities" [paper]
DeepMindらがLLMの意思決定能力を向上させる学習手法Reinforcement Learning Fine-Tuningを提案
この手法の提案の背景にはLLM エージェントを用いた意思決定システムの性能向上を阻害する要因がある。
- 貪欲性 (greediness):過去に高い報酬を得た行動を繰り返し選ぶことで、残りの行動空間をほとんど探索せず、早期に学習が停滞する
- 頻度バイアス (frequency bias):コンテキスト中で最も出現頻度の高い行動を、報酬に関わらず反復的に選び続ける傾向
- 知っているが行動しないギャップ (knowing–doing gap):タスク固有の最適戦略を正しく理解・記述できるにもかかわらず、実際の行動では貪欲な選択を優先し、最適解を実行できない
Reinforcement Learning Fine-Tuningは、(状態, CoT, 行動, 報酬)を複数エピソード分蓄積し、PPO ベースのファインチューニングをおこなう。 探索の担保にCoTを用い、行動候補の検討過程が明示化させる。報酬を与えることで正しい行動を学ぶように最適化する。

実験では強化学習や意思決定問題で扱われるTic-tac-toeやバンディット問題で検証している。 RLFT は「貪欲性」「頻度バイアス」「知っているが行動しないギャップ」の多くを緩和し、意思決定性能を大きく改善したが、まだ古典的アルゴリズムや専門家データ(SFT)完全模倣の性能には達していない。
個人コメント
- 専門家データも不要で、探索環境と報酬を与える仕組みがあれば意思決定の質を高める枠組みができたと捉えられる。
- 一方で、環境から逐次報酬を返せる問題設定がどれだけあるのか、各行動に定量的な報酬を返せるのかが気になる。
- GUI操作のタスクのように各stepに正解か不正解がある問題では使えそう。
- アドバンスドな方法で、検証器を使って中間プロセスに報酬を与えることで、もっと広く実現できそう?
- 一方で、プロンプトのフォーマット指定が強くあるため、そこがビジネス利用ではボトルネックか
- エージェントベンチマークでの体系的評価結果に期待がかかる
AIエージェントの社会実装
"Toward Super Agent System with Hybrid AI Router" [paper]
TensorOpera社からユーザーの多様なニーズを一つの“スーパ―エージェント”で低コストに実現するためのアーキテクチャを提案。 ユーザーのプロンプトを受け取るとまず意図を検出し、専門タスクエージェントへ動的にルーティング、複雑タスク時には自動でマルチエージェントワークフローを生成する。 さらに使うモデルもタスクの難易度に応じて軽量なエッジ上SLM(Small Language Model)と高性能なクラウドLLMを動的に切り替え、レイテンシ・コスト・プライバシーを最適化するモデルルータもある。

個人コメント
- 最近はルーターエージェントが個別エージェントを呼び出す設計が多い。FunctionCallingの仕組みを用いるなど。
- ルーターエージェントが複数のエージェントをどの順番で呼び出すか決めることでマルチエージェントワークフローを実現できる。
- この手の設計で気になるのは、エージェント間でやり取りする情報が規格が定まっているのか。意外と受け渡す情報が大事。
"The AI Scientist-v2: Workshop-Level Automated Scientific Discovery via Agentic Tree Search" [paper]
Sakana AIから研究の自動化のAI Scientist-v2が発表された。ツ研究用の実験コードを作っていく方法にツリー探索を採用している。 [2502.13138] AIDE: AI-Driven Exploration in the Space of Codeと類似する方法に思える。もう少し研究の実行手順に合わせてステージングしているのが違う。 以下の各フェーズでツリー探索している。
- Phase1: プロトタイプ検証 アイデアに基づく最小限の「動くプロトタイプ」を素早く構築し、実現可能性を確認する。
- Phase2: ハイパーパラメータ調整 Stage 1 で得られたプロトタイプをベースに、主要ハイパーパラメータ(学習率、バッチサイズなど)を並列探索し、モデル性能を底上げする。
- Phase3: 主要仮説の検証 論文で報告すべきコア実験(主要仮説の検証)を体系的に実行し、結果を取得する。
- Phase4: アブレーション研究 本実験で用いた各要素(モジュール/正則化項など)の寄与度を定量的に評価し、論文としての根拠を強固にする。
これら4ステージを「①ルートノード設定 → ②拡張ノード選択 → ③子ノード生成 → ④並列実行→ ②に戻る」というサイクルで進め、各ステージ終了後に最良ノードを次ステージのルートとして受け渡す。

応用観点でのコメント
- 実験結果の描画結果をVLMに確認させるのは応用性があると思う。資料の作成においても最終的な見栄えを整えるのは重要で、その部分を直すリフレクションは有益。
- ツリー探索がいいのか、繰り返し目標に向けてリフレクションさせるのがいいのかは考えもの。
- どのコードを拡張するか(ノードを選ぶ基準)はLLMにスコア(0~10)をつけさせているが、何を持って拡張価値が高いか、低いかがLLMの気分による(スコアの基準がない)のが気になる。そこは可能なノード選択肢を全て横並びでランキングさせてあげる方が良さそうな気がする。
- 応用できる研究は既存ライブラリからモデルをインポートして少し改善するようなタイプか、ベンチマークによる評価系や実験系がメインに感じた。AutoMLの延長線に感じなくもない。
- 研究の根深い課題と既存技術の組み合わせで解決できそうな表層的な課題を分けて、根深い課題を解決できるかが気になる。
"UFO2: The Desktop AgentOS" [paper]
MicrosoftからUFOの新作が発表。前回のUFOから大きく変えたのは知覚と行動部分。UFOは画像のみを受け取り、クリックやマウス操作などプリミティブな操作が多かった。
UFO2からの変更点
- アーキテクチャ:マルチエージェントの構造で、ホストから各アプリ専門のエージェントを呼び出す。
- 知覚部分の変更:各アプリのUIの構造情報を取得できるAPI(Windows UI Automation)や取得できない部分をOmniParser-v2で取得するように使い分けている。
- 行動部分の変更:アプリ固有APIを登録し、可能ならAPIで一発呼び出し、ダメならマウス/キーボード操作にフォールバック
- 知識統合:各アプリやAPIのヘルプドキュメントや過去の実行ログをプロンプトに挿入

学習などはせず、純粋なLLMのAPIをラップするようにシステムを作っている。 性能を見ると、前回のバージョンからも格段に上がり、UFO2-base(知識統合なし、行動はマウスやキーボードのみ、知覚にUIAのみ)の性能と比べても、全部のせのUFO2はよく性能が出ている。

個人コメント
- AI Scientist-v2と同じで一度作って終わりにせず、改善をしてv2が出てくるのはそれだけ可能性があり、注力しているのか。
- UFO2 は、推論ベースなエージェントの構築の模範にすべき事例だと思う。書ききれない部分でよく設計されている。
- 使用用途をWindowsデスクトップアプリの自動化に限定したことで、汎用性を失った部分はあるけれど、そのおかげで作り込める部分を作り込んだ印象。
- まだまだ商用向けに作り込める部分は多くあるように見えるし、モデルの性能も上がっていけば、徐々に使い物になりそう。
"AgentA/B: Automated and Scalable Web A/B Testing with Interactive LLM Agents" [paper]
AgentA/Bは、エンドツーエンドの自動A/Bテストプラットフォーム。 ユーザー指定の属性(年齢、職業、購買目標など)に基づき、数万~数十万の多様な仮想ユーザーペルソナをLLMで自動生成。 その後、ペルソナをグルーピングし、ペルソナにWebサイトを操作させ、実行ログを分析してダッシュボード形式で可視化などする。

人間と比較すると、人間ユーザーは広範に探索する傾向が強く、多数の検索やクリックを行うのに対し、エージェントはよりゴール指向で短いステップで完結する傾向がある。 それでは意味がないように思うが、購入完了率やフィルタ選択の増減など、主要なUX評価指標はエージェントでも人間と同方向の変化を捉えられており、デザイン差を検出する有効性を示せたらしい。

個人コメント
- アイデアは2023年からあったが、当時よりアプリケーション向けに作り込まれている。
- 現状はAIエージェントが最短経路でタスクを完遂する“賢い”仮想ユーザーになってしまっている。無駄な行動が人間より少ない。
- 簡易検証を少額でクイックに試せるのは良さそうだけど、目新しさで流行って、継続して使い続けたいと思うかは分かれそう。
"UXAgent: A System for Simulating Usability Testing of Web Design with LLM Agents" [paper]
Amazonの研究者らが大学と共同で研究したユーザビリティテストの自動化研究。UXデザイナーに高速フィードバックを返せるのが業務上の魅力。 エージェントには、人間の思考のSystem1 & 2を模倣するようなフレームワークを用意している。メモリなども用意している。 環境は、Universal Browser Connectorを介してAmazon.comやGoogle Flightsなど実際のWebページをSelenium経由で操作し、リアルなユーザ行動をシミュレーションする 。

UX研究者5名は、UXエージェントが「ジャケットを購入する」タスク(60ペルソナが45/60で75%の成功率)を実行した操作動画やその時の思考ログを見て、どれくらいUXエージェントが人間のテスターになりきれているかを評価した。
5段階評価で、現実感が3.0、有用性が3.4、信頼性が3.6で明瞭性や理解の容易性が4.0の結果。 解釈すると、現実感は薄く、有用性は低めなので、ペルソナやニ段階の思考を入れてもやはり人間らしさは出ていない。一方で、システム的には分かりやすいという結果。
機能別で有用性を評価した結果、エージェントの実行結果の動画が一番低く2.8点、アクショントレースやエージェントへの追加インタビューチャットがそれぞれ4.2, 4.8と高い。 理由は、「問題となりうる操作だけを抽出して確認したい」というニーズが強く、動画だと原因分析がしづらいためだそう。
個人コメント
- 結果だけ見ると、使えないと言っているようにしか感じない。現実感が低く、有用性もほどほど。
- 有用性の高い要因に追加インタビューチャット機能があるが、その追加質問の回答は実際にエージェントが操作した時の思考と同一と考えられるほど論理的な整合性があるのか。例えば、「なぜその操作をしたのか」と聞いて、回答を信頼できるのか。回答した理由と同じような場面に遭遇したら、そのエージェントは同じロジックで動くのか。所詮はそれっぽいことを言っているだけに感じてしまわないのかが気になる。
- エージェントの思考機能は評価が普通で、むしろどの行動をしたのかの方が評価が高いので、エージェントアプリでも何の行動をしたのかはアプリとしても表示方法に気をつけたほうが良さそう。
- 人間の実際のデータと比較していないので、どれだけペルソナの行動がリアルなのかが疑問。先の研究と合わせて考えると無駄な行動が少なく、ペルソナの特徴が行動に反映されていないのかもしれない。
評価データセット作成
⚖️ "BrowseComp: A Simple Yet Challenging Benchmark for Browsing Agents" [paper]
OpenAI らが、AIエージェントのウェブブラウジング能力「ウェブを効率よく巡る力」を評価するためのベンチマーク。1,266問の「難易度が高く、かつ短い答えで検証しやすい」質問から構成される。 持続的かつ創造的に情報を探索できるかを測定する。
作問方法と評価結果を説明すると、作問方法は、ある特定の事実に対して、そこから複数の属性(背景、発生時期、人数など)を組み合わせ、「解くのに10分以上かかるが、答えは短く一意で検証しやすい」ように逆質問形式で作る。 特に作った問題は、OpenAI o1のような既存モデルで不正解であること、Google検索結果の上位にないこと、人間による検証で10分以内で解けないことを満たす必要がある。 回答が評価しやすいように「短い文字列」(例:チーム名、人物名、論文タイトルなど)にしておくのがポイント。
問題の例「1990年から1994年の間に行われたサッカーの試合で、審判がブラジル人、イエローカードが両チーム合わせて4枚(各チーム2枚)出され、そのうち3枚は前半ではなく、交代が4回あり、そのうち1回は試合開始から25分以内の負傷交代であった。どの対戦カードか?」 → Answer: Ireland v Romania
人間トレーナー(AIアシスタント利用禁止、2時間まで探索)は1,255問中367問(29.2%)を解答でき、そのうち86.4%が解答と一致した。 モデル間で比較すると精度はGPT-4o (閲覧なし) 0.6 %、GPT-4o w/ browsing 1.9 %、GPT-4.5 0.9 %、OpenAI o1 9.9 %、Deep Research (ベースライン)51.5 %となった。GPT-4o w/ browsing が低迷する一方、推論特化の o1 が若干優位であることから、単純なツール呼び出し以上に「検索戦略」と「情報解釈/合成力」が重要であると示唆される。
個人コメント
- Deep Researchの回答率が凄まじい。
- 評価データセットの作成に相当時間をかけているが、作成後は人が評価に介在しないように工夫されている。
- 業務特化でエージェントを作ったときにどうしても人間評価が入り、サイクルが回しにくいことがある。
- 人の評価にかける労力がプロジェクトを進めるに連れて、徐々に減らせる工夫が今後求められていくと思う。
サーベイ論文
📖 "Meta-Thinking in LLMs via Multi-Agent Reinforcement Learning: A Survey" [paper]
「メタ思考」とは、LLMが自らの思考過程を内省し、評価・制御する能力を指す。 このサーベイ論文では、メタ思考を獲得するMARL手法をサーベイし、整理している。

図の3つの要素が組み合わさることで、LLM は内省→自己評価→修正→再生成、というメタ思考ループを強化学習の枠組みで習得し、従来の一方向的生成に留まらない「自ら考え直し、改善する」能力を獲得する。
📖 "A Survey of Frontiers in LLM Reasoning: Inference Scaling, Learning to Reason, and Agentic Systems" [paper]
最近の研究トレンドが構造化されて整理されているので、下手な本より読む価値があると思う。 頭の整理と用語の理解にもちょうど良い。

正直、LLM周りの応用って総合格闘技的に様々な技術(AI技術(NLP、DNN、RL、確率、最適化)やシステム系など)が合わさっているので学生は理解するのが辛そうな感じがする。そんなことないのかな。

📖 "Challenges and Paths Towards AI for Software Engineering"[paper]
AIによるソフトウェア開発の自動化の課題がわかりやすく整理されている。

📖 "A Survey of AI Agent Protocols" [paper]
エージェントプロトコルは、エージェントと外部リソース間およびエージェントとエージェント間の通信ルール・データ形式・手順を定義する標準化フレームワークである。 それらについて、まとめたサーベイ論文。図を見るだけで十分。


📖 "Advances and Challenges in Foundation Agents: From Brain-Inspired Intelligence to Evolutionary, Collaborative, and Safe Systems"[paper]
書籍並みの分量だけど、読みたいところだけ読むならたいした分量じゃないので知らない概念や興味あるトピックだけ探せば良さそう。 エージェントの進化やマルチエージェント系もトピックがある。
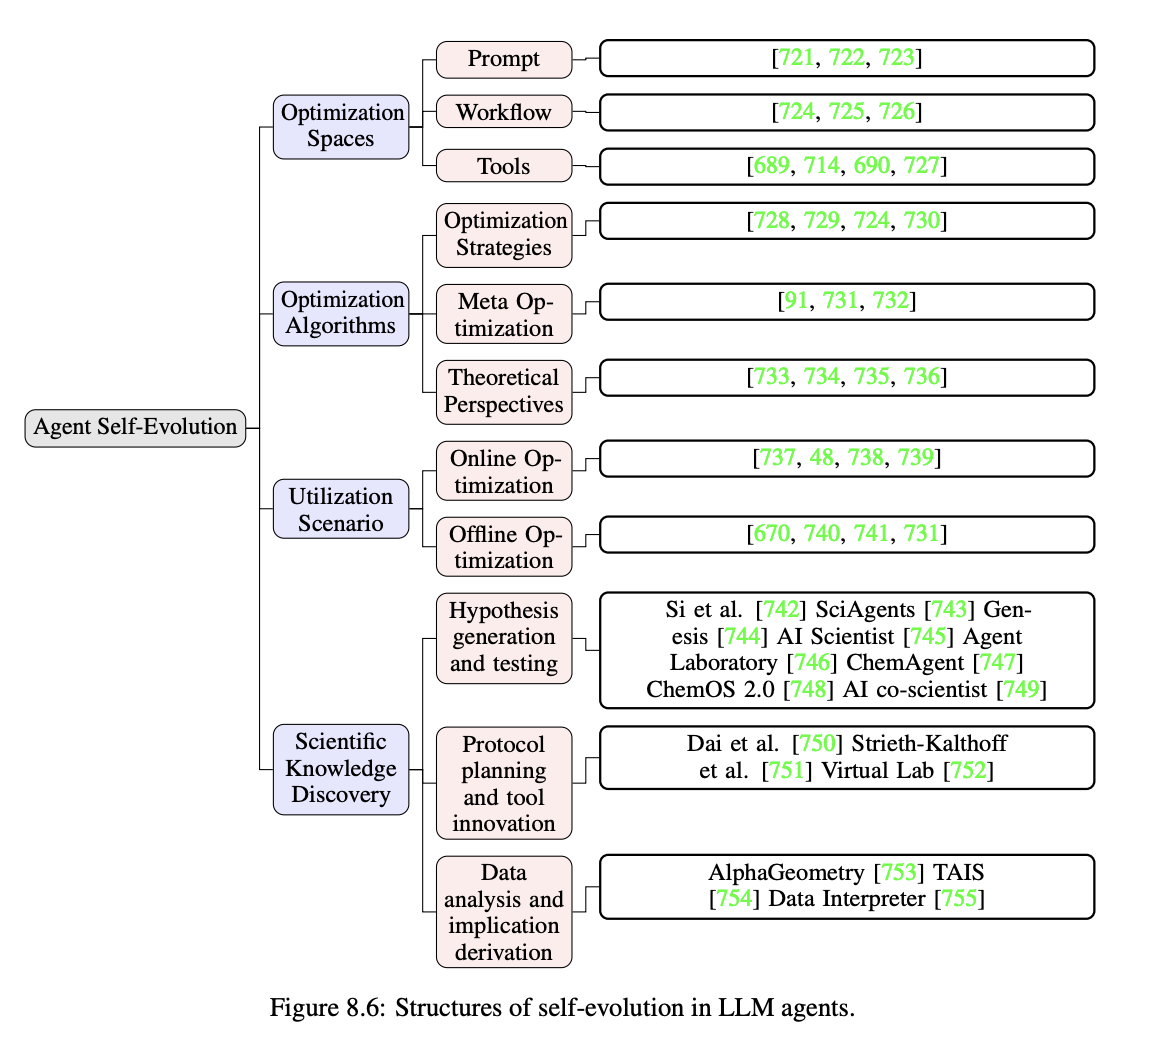

📖 "Adaptive Human-Agent Teaming: A Review of Empirical Studies from the Process Dynamics Perspective" [paper]
人間とエージェントが協働する「Human‑Agent Teaming(HAT)」の研究に対するサーベイ。 既存研究は役割の明確化やチーム開発の方法論が多く、チームの改善やチーム形成に関する研究は少ない。

最後に
特に書くことはないのですが、AIエージェントって面白いんですよね。 ビジネスの文脈と研究開発の文脈で乖離が大きくなってはいるものの、どちらにも違った面白さがあると思います。
ビジネスの場面では、業務の複雑さや歪さを学びながら、改めて人間の賢さをAIエージェントをチューニングしながら感じれます。 エンジニアリングでも、一つの課題に対して、色んなAIエージェントのワークフローが思いつくし、それぞれの得手不得手やトレードオフを想像しながら、どれを選択するのか決める設計も楽しいです。
研究的には、僕はエージェントの自己進化に向けた研究に興味があって、メタエージェントによるエージェント構築や自己探索の効率化、質の高い検証器(報酬)の構築、スキル獲得、プロンプトの最適化など。 それぞれは違う文脈で研究されているけれど、まとめていくとエージェントの自己進化につながっていくように感じます。
最後に今日説明した技術の一部は、ビジネス側でも使えると思っています。AI EXPOでも登壇してお話ししたのですが、ある研究内容をそのままビジネスに適応するのではなく、研究の問題設定のドメインを変えたり、タスクを変えたり、何かしらシフトさせて実課題に充てることで、少なくとも業界で最初の事例を作り出せると思っています。
今年一年の振り返り
太田 (https://x.com/ottamm_190) です。
今年もお世話になりました。 私は生成AIエージェントに燃え続けた一年です。
仕事では様々なAIアルゴリズム検証、バックエンド開発をしつつ、エージェントの技術検証のリードをしてました。
アウトプットしたものを振り返ってみます。我ながらたくさん発信してますね。
発信したものが皆さんの勉強につながったり、業務に役立てられていたら嬉しいです。
| 年月 | タイトル | Weekly AI Agents News! |
|---|---|---|
| 2023年12月 | - 資料)LLMマルチエージェントを俯瞰する |
|
| 2024年1月 | - 資料)生成AIを用いたText to SQLの最前線 | |
| 2024年2月 | - ブログ)社内取り組み(海外ニュース要約) - ブログ)マルチモーダルRAGの実装方針 |
|
| 2024年3月 | - ブログ)LLM生成結果をAzureのLog Analyticsで監視する方法 | |
| 2024年4月 | - 資料)ICLRのLLMエージェント論文調査まとめ | - 論文紹介編 - プロダクトニュース編 |
| 2024年5月 | - 資料)生成AIエージェントの現状を俯瞰する - ブログ)ヘルプデスク向けエージェント開発活動のTips |
- 論文紹介編 - プロダクトニュース編 |
| 2024年6月 | - 登壇)JSAI企業セッション発表(エージェントの取り組み) |
- 論文紹介編 - プロダクトニュース編 |
| 2024年7月 | - 登壇)TokyoAI主催イベント AIエージェント - 出張ブログ)ICML2024現地参加レポート |
- 論文紹介編 - プロダクトニュース編 |
| 2024年8月 | (外部発信なし) | - 論文紹介編 - プロダクトニュース編 |
| 2024年9月 | - 録音)Algomatic社とのSpotify対談 | - 論文紹介編 - プロダクトニュース編 |
| 2024年10月 | (外部発信なし) | - 論文紹介編 - プロダクトニュース編 |
| 2024年11月 | - ブログ)エージェント総括:技術動向 - ブログ)エージェントのビジネス活用解説 - リポジトリ)Weekly AI Agents News!論文リポジトリ |
- 論文紹介編 - プロダクトニュース編 |
| 2024年12月 | - ブログ)エージェントビジネスの勘所 - ブログ)今年のエージェント論文16選 |
- 論文紹介編 - プロダクトニュース編 |
今年読んで良かった本
先にまとめておきます。
今年のAIビジネスは学習から推論に戻ったので、当時の状況を知るために読んだら今に通じる話しかなくて参考になりました。
エージェントの計画能力に通じる話が多く、人間を学びAIを学べたと思っています。
質の高い計画にはシミュレーションや経験が重要で、オリンピックは同国の開催が数十年空くため、前回の経験がいきないため失敗する。
自動化といえば、ビジネスではRPAが存在し、そのビジネス状況を知るのに勉強になりました。
エージェントでその課題を解決できるのか。
生成AIのビジネス向けの書籍が数ある中でビジネス層向けの表現の仕方、伝え方が勉強になりました。
2024年1月
2023年の年末に出した「LLMマルチエージェントを俯瞰する」が好評でした。 当時、RAG人気が過熱する中でエージェントって聞き覚えのない言葉だったと思うんですけど、興味を持ってくれた人が多かったようです。 自分自身、資料にまとめたことで今後のエージェントの取り組む方向性を絞るきっかけになりました。 実際に社内でも事前評価であるレビューやシミュレーションは案件相談をもらえたので良かったです。
他には仕事の関係で年末年始の間に調べてたText-to-SQLを使った手法も公開しました。 SQLクエリ生成の限界や勘所、プロンプトエンジニアリングの工夫など、データ集計方法を学べました。 speakerdeck.com
2024年2月
社内取り組みです。数ヶ月前から取り組んでいたものを改めて記事にしました。 海外のニュースをネットでバズったものだけ拾うんじゃなくて、幅広く情報を集める試みです。 情報の質の担保とニュースの詳細が知りたくなるメッセージ性が難しいですね。
マルチモーダルRAGの実装方針も公開しました。昨年末に取り組んでいた内容を改めて記事にしています。 画像とテキストのハイブリッド検索による方法とマルチモーダル埋め込みを使う方法を紹介しています。
2024年3月
LLMアプリではLLMが変わると挙動が変化し、今までのプロンプトが効かなくなることがあります。 そこで、LLMの生成結果をAzureのLog Analyticsで監視する方法を記事にしました。
2024年4月
年明け以降自主的に調査していた国際会議ICLRのLLMエージェントの論文調査です。 マルチエージェントは調べていましたが、自律エージェントに関しては調べが浅かったので体系化をしました。 エージェントの応用や基礎能力を自分なりに分類してまとめました。
2024年5月
社内の技術者に端的にエージェントとは何かを伝えるための資料を作り公開しました。 エージェントの応用を中心にどんなときエージェントが使えそうかを整理して社内で利用していました。
ヘルプデスク向けエージェント開発活動を年明け以降していたので、その取り組み内容を公開しました。 この活動でエージェントの癖や開発のノウハウを貯めることができました。
2024年6月
JSAIに参加し、エージェントの取り組み内容を企業セッションで発表しました。 今年はエージェントを発表している企業は少なかったですね。来年はどこもエージェントと言っていそうです。
2024年7月
TokyoAIのイベントに招待され、AIエージェントについて発表してきました。 ヘルプデスクエージェントをベースにエージェントの概念や開発ノウハウを説明してきました。
応用機械学習と人工知能セミナー: AIエージェント - connpass
7月下旬にはICMLに現地参加し、LLMやエージェントの熱量や動向を自分の目で見て、レポートにしました。
2024年8月
特に外部発信はありません。
2024年9月
Algomatic社とは2024年の3月くらいからエージェント繋がりで交流を続けており、Spotifyでエージェントについて語ってきました。
2024年10月
特に外部発信はありません。
2024年11月
11月から育休に入り、しばらく仕事はお休みです。
年末に向けてエージェントに関する総括を公開しました。 技術動向とビジネス動向をそれぞれブログに書きました。
Weekly AI Agents News! で取り上げた論文をリポジトリにまとめました。 論文へのアクセスはしやすくなったと思います。 github.com
2024年12月
OpenAIからの発表やGoogleの発表を毎日楽しみにしていた毎日でしたね。 やっと育児の生活リズムが作れてきました。
コラムの後半戦で、エージェントの能力が最大限にいきそうな業務の特徴をまとめました。 masamasa59.hatenablog.com
1年間通して、読んで良かったと思う論文を満遍なくチョイスした論文リストです。 ちゃんと読めばエージェントのことがよくわかると思います! masamasa59.hatenablog.com
来年に向けて
育休明けたら、またエージェント開発したり、新たな企画立てたり、PoCを進めたりしたいですね。 今年以上にイベントやユーザー会、顧客との意見交換の場に参加して、現場の解像度高めながら取り組んでもいきたいです。
2024年生成AIエージェントのおすすめ論文 16選
こんにちは! AIエージェントに一年を捧げた太田(https://x.com/ottamm_190)です。
年末のエージェント記事の第四弾です。
第一弾→ Weekly AI Agent News!から見えたAIエージェントの現在地 - 襖からキリン
第二弾→ AIエージェントビジネスの現状と今後の考察 - 襖からキリン
第三弾→ 生成AIエージェントが刺さる業務課題を探そう! - 襖からキリン
今年のWeekly AI Agents News!を更新し続けて個人的に学びがあった論文を紹介します。 特に研究者よりかはビジネス層やエンジニア層に読んで学びがありそうなのを満遍なく16本紹介します。
キリ良く15本には削れなかったですね。はい。
ぜひ、年末にお手元の生成AIを使って読んでみてください。
質問例も載せておきます。(生成結果は確認していませんが、当時聞いたような記憶もあります。)
- 1) AIエージェントの要点を押さえてコンパクトに学べる
- 2) AIエージェントをガッツリ知れる
- 3) CoTが有効なタスクとは何か
- 4) AIエージェントの何を評価するか
- 5) Large Reasoning Models は計画できるのか
- 6) LLMは実世界の制約条件やルールを守れるのか
- 7) RAGをエージェント化すると何が変わるのか
- 8) 生成AI時代のデータ分析はどう変わるのか
- 9) ソフトウェア開発でAIエージェントは何ができるのか
- 10) GUIを操作するAIエージェントの裏側ってどうなってるのか
- 11) AIエージェント構築時のポイントとは何か
- 12) マルチエージェントで問題解決するにはどうするのか
- 13) AIエージェントと人間のタッチポイントを設計するにはどうするのか
- 14) AIエージェントの学習はどうするのか
- 15) フロンティアモデルはメタ認知能力があるのか
- 16) AIエージェントに脱出ゲームをクリアできるのか
- この記事もおすすめです!
- 最後に
1) AIエージェントの要点を押さえてコンパクトに学べる
AIエージェントの用語やエージェントのアーキテクチャの移り変わりが分かります。 最初にざっくり理解するならこの論文ですかね。
おすすめ質問:「エージェントに関する用語を説明して」「シングル(マルチ)エージェントの手法の違いを教えて」
2) AIエージェントをガッツリ知れる
エージェントの歴史から最近のエージェントの応用まで、どんな方法があるのか体形立てて知れます。図だけ見ても理解できると思います!
おすすめ質問:「今までのエージェントの歴史を教えて」「エージェントの応用アプリをエージェントが使われる理由を含めて教えて」
3) CoTが有効なタスクとは何か
推論能力向上にCoTをベースにした方法が多い中、元々のCoTが効果的なタスクは何でしょうか。
o1-previewが発表されてから、o1の学習に使われているとされるCoTが再注目され、その最中に発表された論文です。
いつでも銀の弾丸はないと心に留めておきたいですね。
おすすめ質問:「CoTが有効なタスクと効果がないタスクは何ですか。どんな実験設定で評価したかも教えてください。」
4) AIエージェントの何を評価するか
何ができたらエージェントなの?みたいな話がありますが、アカデミックでは何を重視しているのかが分かります。 最初の図だけ見て理解してもらえたら十分です。
おすすめ質問:「どんな実験設定で何を評価しましたか」「具体的なタスクの例を教えてください」「LLMやエージェントの得手不得手を教えて」
5) Large Reasoning Models は計画できるのか
LLMでは前提条件をもとに目標に向けて手順を構築する計画が苦手でした。 o1-previewでは計画の成功率が劇的に改善されていたという結果に。論文中の表の結果だけ見てもらえれば十分です。
おすすめ質問:「Large Reasoning Modelsとは何ですか」「どんな実験設定で実験結果はどうでしたか」
6) LLMは実世界の制約条件やルールを守れるのか
人間社会は税制や規制など、ルールで雁字搦めになっています。 しかもある制約は別の制約に依存したりと、参照関係が全てリンクされていればいいですが、管理含めて職人技です。 ルールに従っているかを確認しようものなら、複数のルールを調べて全てクリアできるか判断する必要があります。 この論文はまさにそのルール遵守能力を評価しています。
おすすめ質問:「どんな実験設定で何を評価しましたか」「具体的なタスクの例を教えてください」「どうすればルールや制約条件を漏れなく守れるようになれますか」
7) RAGをエージェント化すると何が変わるのか
従来のRAGアルゴリズムからエージェント化する必要性を知るのにちょうど良い論文です。図もわかりやすいです。
おすすめ質問:「Agentic IRって何?」「何で必要なの?」「具体例を教えて」「RAGとの違いは何?」
8) 生成AI時代のデータ分析はどう変わるのか
LLMのコード生成、仮説思考、数値の読み取りを活かしてデータ分析ができるようになりました。 どう体験が変わっていくのかも考えさせれます。
おすすめ質問:「生成AI時代のデータ分析はどう変わると述べていますか、理由も教えてください」「具体的な応用例を教えてください」
9) ソフトウェア開発でAIエージェントは何ができるのか
ソフトウェア開発の支援サービスが多く出る中で、根源的にエージェントはどんな貢献ができるのかが知れます。 この論文は特に図解に力を入れています。
おすすめ質問:「エージェントとは何ですか」「ソフトウェア開発のどの場面でエージェントが活用できますか、理由も教えてください」
10) GUIを操作するAIエージェントの裏側ってどうなってるのか
今年は、AnthropicのComputer UseやGoogleのProject Marinerのようにブラウザを操作するエージェントが出てきました。今後、使っていくにしても、作る側になるにしても、この論文を読めば、その裏側が知れます。 この論文は特に図がわかりやすいです。図のわかりやすさって大切ですよね。
おすすめ質問:「GUIを操作するAIエージェントの概要を教えて」「タスクの実行例をステップレベルで教えてください」「どこで応用されますか、何が現状の技術的な課題ですか」
11) AIエージェント構築時のポイントとは何か
エージェントを設計するとき、計画やメモリ、ツール、制御フローをどうするべきかある程度の方針が知れます。
おすすめ質問:「AIエージェント構築時のポイントを詳細に教えて」
12) マルチエージェントで問題解決するにはどうするのか
今年、マルチエージェントを簡単に作れるフレームワークがopenaiからもSwarm で出ましたね。他にもAutoGenやCrewAI、LangGraphもあります。 どんなマルチエージェントを作りますか?参考の一つとして、汎用的に問題解決を目指す設計で専門的なエージェントを用意し、専門的なエージェントをコントロールするオーケストレータがいる設定の論文を紹介します。
おすすめ質問:「提案手法の詳細を教えて」「この論文での専門的なエージェントとは?」「専門的なエージェントをシングルエージェントでいうツールと見なすことはできますか」
13) AIエージェントと人間のタッチポイントを設計するにはどうするのか
エージェントが動くようにするのに時間を使いがちですが、人間とのタッチポイントをどうするべきかを考えさせてくれます。
おすすめ質問:「エージェントアプリのUXを考える上で考慮すべきことは何ですか」「どんな解決策が考えられますか」
14) AIエージェントの学習はどうするのか
LLMの推論をベースにエージェントを作る方法で精度が出なくなると学習に入ります。その学習方法の一つである大規模行動モデルの作り方が丁寧に解説されています。
おすすめ質問:「大規模行動モデルとは何ですか、どのように作りますか」「LAMを使ったタスクは一般的に何がありますか」「どのようにタスクを解くかステップレベルで教えて」「LAMとLLM Agentsとの違いは?」
15) フロンティアモデルはメタ認知能力があるのか
個人的に本当にできるようになるの?と思いながら注視している話題です。 エージェントに俯瞰的に自分の状態と限界を理解した上で行動をしてほしいです。 例えば、自分の手元に集めた知識をもとに追加で必要な情報をあらためて考えたり、何度かツールを使っても上手くいかず、ツールが悪いのでは?と考えたりしてほしいですよね。そんなことを評価しています。
おすすめ質問:「どんなタスクをなぜ解きましたか」「タスクの具体例を挙げて」「それぞれの実験結果を教えて」
16) AIエージェントに脱出ゲームをクリアできるのか
これも面白いなーと個人的に思ったので載せちゃいました。 この論文は脱出ゲームを題材に長期的な計画や創造力を評価しています。脱出ゲームはエージェントを評価するいい題材だなーと思っています。 創造力は小説とか物語で評価している論文がありますが、脱出ゲームは的を得ていると思いました。
脱出ゲームでは最初は探索的な行動をして色々観察します。そして暗証番号を入力するような謎解きが現れたらそれがサブタスクになります。そして、その謎は一つではなく探索すればいくつも見つかります。つまり、エージェントはタスク管理が必要になります。
謎解きを解くために行動をして、アイテムを拾ったら、スタックされている謎解きに役立つか考える必要があります。 ときにアイテムリストの中からアイテムを繋ぎ合わせて別のアイテムを作る必要もあります。 そういった一つ一つのひらめきと創造力が求められながら、環境と相互作用し、脱出を試みるタスクなのです。
まさにエージェントの自律性と知性の両方が求められる良い題材です。
おすすめ質問:「どんなタスクをなぜ解きましたか」「提案手法を詳細に教えて」「実験結果を詳細に教えて」「課題は何ですか」
この記事もおすすめです!
私が書く以前に既に公開されていて、良いまとめだと思ったので紹介します。 私が紹介した論文たちは取り上げた記事の論文と被らないようにしています。
1つ目、15 Agentic Systems and Frameworks of 2024
記事では2024年に作り込まれたエージェントを厳選して紹介しています。 詳細は記事を見てほしいですが、私もこの記事で取り上げている6割はSNSで話題だったと思っています!
- GUI Agents
- Agent K v1.0
- The AI Scientist ←取り上げたかった
- MALT
- Agent S
- ADAS ←取り上げたかった
- AgentInstruct ←取り上げたかった
- AgentStore
- WALL-E
- Generative Agent Simulations of 1,000 People ←取り上げたかった
- DynaSaur
- PRefLexOR
- Genex
- Bel Esprit
- AutoKaggle ←取り上げたかった
2つ目、AI Agents Research Papers: Best of 2024 - Analytics Vidhya
記事では、LLMをベースにしたエージェントや2024年に公開されたかに関わらず、研究よりの俯瞰的に概念や体型を理解する上で"エージェント" についてインパクトのある論文を挙げています。 実務寄りではないですけど、リサーチャーはむしろこっちのリストの方が好きかもしれません。
- Modelling Social Action for AI Agents
- Visibility into AI Agents
- Artificial Intelligence and Virtual Worlds – Toward Human-Level AI Agents
- Intelligent Agents: Theory and Practice
- TPTU: Task Planning and Tool Usage of Large Language Model-based AI Agents
- A Survey on Context-Aware Multi-Agent Systems: Techniques, Challenges and Future Directions
- Agent AI: Surveying the Horizons of Multimodal Interaction
- Large Language Model-Based Multi-Agents: A Survey of Progress and Challenges
- The Rise and Potential of Large Language Model-Based Agents: A Survey
- A Survey of Progress on Cooperative Multi-Agent Reinforcement Learning in Open Environment
最後に
これで年末AIエージェントブログ連弾は以上です。 11月中旬から育休に入ったというのもあり、普段ブログは書かないんですけど、隙間時間を見つけて書いてみました。 4本書いたんですけど、どれも文量が多くてすみません。でも自分の考えていることは文章にできたかなと思います! 公開してから文章おかしいなと気づいて直したり、表現変えたり、過激だなーと思って消したり(笑)、何度かしています! この記事で紹介した論文を読んでから、僕のコラムを読むと違った理解ができる部分もあるかと思います。 是非、また読んでみてください。
ちなみに今日紹介した論文は基本的に自分の論文リポジトリで🔥マークをつけています! 他にも興味ある方は見てください。
では!
生成AIエージェントが刺さる業務課題を探そう!
こんにちは! AIエージェントに捧げた一年を過ごした太田(https://x.com/ottamm_190)です。
年末のエージェント記事の第三弾です。
第一弾→ Weekly AI Agent News!から見えたAIエージェントの現在地 - 襖からキリン
第二弾→ AIエージェントビジネスの現状と今後の考察 - 襖からキリン
今年は業務時間外でAIエージェントのニュースや論文を発信してきました。論文リストもまとめています。 興味があればご覧ください。とりあえず3月末までは更新します。
さて中身に入ります。記事のタイトル通り、生成AIエージェントが刺さる業務課題を探す道標を紹介します。
DX部門や受託コンサルの方をメインに、PdMの方も参考になると思います。
そろそろ会社の上の方から生成AIエージェントの事例を集めさせられ、戦略を考えさせられたり、社内の事例を出すように言われたりしていますか。
そもそもエージェントが刺さる課題を探そうとも、自ら歩み寄ってくることはありません。 ケーパ資料やデモ、事例を持っていろんな方に説明をして課題を探しにいく必要があります。
無闇に探すより少しはアテがある方が議論しやすいです。 この記事がそんな課題を探すきっかけや助けになると書いた甲斐があります。
(12/24に追記です。)
記事の前提として、第二弾で書いたように、生成AIエージェントは世の中で自動化したいことの一部で有効活用できると考えています。多くは業務フローに沿ってプロンプトを繋げたワークフローで解決できると考えています。それでもエージェントを何か活用したいという場合に、役立つ内容をまとめているつもりです。

その前提でご覧ください。
- あなたは生成AIエージェントでどんな成果を出したいですか?
- 生成AIエージェントの特徴を振り返る
- 生成AIエージェントが取り組むタスクの抽象度を誤ってはいけない
- エージェントが刺さる業務の特徴7選
- 逆に刺さらない業務の特徴とは
- まとめ
あなたは生成AIエージェントでどんな成果を出したいですか?
多くの企業がエージェントを取り組もうと来年さらに動くでしょう。
そんなとき、あなたのモチベーションはどこにありますか。
- 先行事例にある問題設定でも現場に受け入れられ、確実に効果があることを実感したい
- 競合他社にまだないエージェントの応用事例をいち早く生み出したい
- 技術的に何か優れたエージェントを開発した事例を作りたい
この記事は今までにない応用事例を作りたい方向けに、どんな業務の特徴があれば適応できそうかを掘り下げます。
先行事例に習って確実にエージェントに取り組みたい場合は、来年の春か夏まで待てば、早期取り組み層からPoCの結果が公開されると思います。 少しでもエージェントを触ってみたい場合は、MicrosoftやGoogle、Amazonなどから提供されるエージェントビルダーを活用するのも手です。
生成AIエージェントの特徴を振り返る
生成AIエージェントは、LLMをコアに、タスクの計画立案→外部ツールを使った実行→結果を元にした自己修正を繰り返しながら、目的のアウトプットに近づいていきます。
従来型のQ&AチャットボットやRPAは、事前定義されたルールやシナリオに沿って動くことが一般的でしたが、生成AIエージェントは推論能力を活用して能動的に方針を修正できる点が大きく異なります。
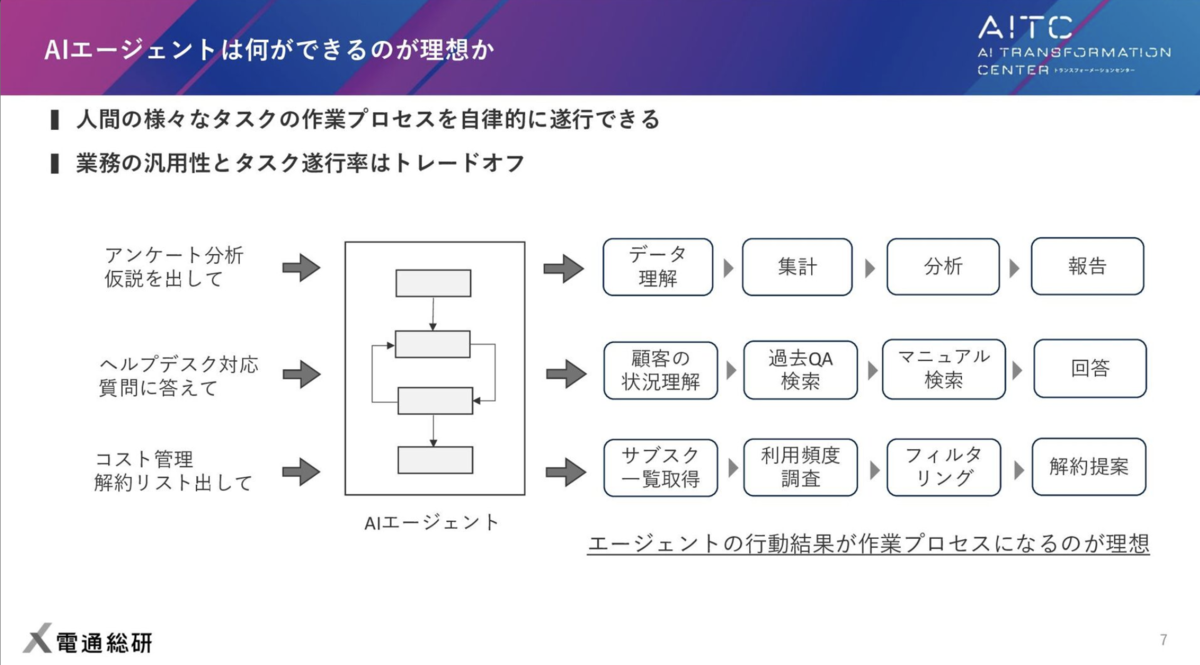
ヘルプデスクの事例で学ぶAIエージェント - Speaker Deck
従来のようにファインチューニングのような学習が必要な場合、データの整備・アノテーションに工数がかかりました。また解くタスクも基本的に一つで、別用途で横展開するときは再度学習が必要でした。
しかし、汎用的に学習されたLLMをエージェント化するアプローチでは、一定のプロンプトとツールを変えるだけで多彩な課題に取り組むことができます。 汎用と特化のトレードオフはありますが、横展開の可能性が従来の学習とは違います。
最後に生成AIエージェントは、外部API、RPAツール、チャットツール、データベースなどと連携できます。こうした“ツールの組み合わせ”が重要な場面ほど、エージェントは価値を発揮しやすくなります。
※ エージェントは各社で様々な定義がありますので、自社の定義や特徴と合わなくても気にしないでください。根幹の技術は同じですが、その根本技術が一つではないので、自社の強みに活かすようにエージェントの重視する観点を強調すると各社で説明が変わってきます。
以下の最近出たAnthropic のブログのエージェントの考え方に私は近いです。
Building effective agents \ Anthropic
生成AIエージェントが取り組むタスクの抽象度を誤ってはいけない
細かいことを話す前に、大前提としてエージェントが扱うタスクの抽象度を誤ってはいけない話をします。
エージェントを使うビジネスで一番変わったのは、扱えるタスクの抽象度です。 この理解を間違えると、不必要なときに無理してエージェントを使うことになるか、エージェントを作ろうとしていつの間にかエージェントではないものを作っています。
よくあるのは、受託コンサルで顧客の業務課題を詳細に聞いて、その業務のためだけに作れば作るほど、目的ごとの複数のプロンプトを繋ぎ合わせた事前定義のワークフローになっていくことです。
いつの間にかエージェントの強みだったタスクの抽象度が低くなり、それはもうLLMを使った特定の業務代替用のワークフローじゃん!になります。
生成AIエージェントは自ら業務の解決プロセスを思考して実行するぐらいの気持ちでいいです。
エージェントを形作るワークフローは思考回路みたいなものであって、業務の実行ワークフローとは別ものです。
その思考の方向性をプロンプトで縛り、業務特化にしていくイメージです。
一概に全てがそうではありませんが、6割くらいはその思想です。 残りにマルチエージェントの思想で、業務の職務担当者や目的レベルでエージェントと呼び、業務ワークフローに合わせてエージェントを繋ぎ合わせる思想と汎用的な設計でオーケストレーターが適切な役割のエージェントを選ぶ思想があります。
タスクの抽象度が高いほど「エージェントらしさ」が活きる
既存のGoogleやOpenAI の既存のエージェントの応用事例はどれもタスクの抽象度が高いです。 どんな事例かというと、データ分析、ソフトウェア開発、Webナビゲーション、Web情報検索による質問応答です。
Introducing canvas, a new way to write and code with ChatGPT. | OpenAI
Google introduces Gemini 2.0: A new AI model for the agentic era
共通するのは、どれも入力にどんな質問や指示が来るか事前に予想できないので、その都度行動方針を決めるレベルで抽象度が高いタスクなのです。
タスクの抽象度を理解するために抽象度の低い例から高い例を紹介します。
抽象度 低:ある定点観測しているアンケート分析のためのエージェント
データ分析タスクで一番抽象度が低い例です。事前に分析項目も決まって、報告する形も定まり、事前定義のワークフローになりやすいです。 受託コンサルで特定の部署向けに案件を受注するとこの抽象度の案件が多くないでしょうか?抽象度 中:任意のアンケート分析のためのエージェント
データ分析タスクの抽象度を一段あげました。利用満足度のアンケートや市場調査のアンケートなど目的ごとに形式や分析プロセスが異なり、計画する必要が出てきます。社内向けエージェントを全社展開で利用してもらえるのはこのレイヤーではないでしょうか?抽象度 高:テーブルデータ分析のためのエージェント
更にタスクの抽象度をあげました。入力がアンケート以外に売り上げデータや勤怠データなどが想定され、分析方針も都度変わり、難易度が高いです。ここまで上げると今の技術で現場で満足いく結果が出るか不安ですね。
基本的にタスクの抽象度が上がるほど、エージェントが自ら計画をして進めます。そしてワークフローが事前定義されていないので、自分でツールを選ぶ必要があり、間違いがあれば自分で気づいて直す必要が出てきます。
業務特化のエージェントを作るのは、ちょうど真ん中の「任意のアンケート分析のためのエージェント」くらいのイメージです。 このレベルが現状開発するならちょうどいい難易度だと考えています。
タスクの抽象度を高める視点は、一つの部署だけでなく、複数の部署で同じようなことをしているかです。 このような業務は、解決策の方針は似ていますが、細部はその都度、各部署に調節する必要があり、結果的にタスクの抽象度が一段高くなります。
エージェントが刺さる業務の特徴7選
エージェントが扱うタスクの抽象度は先ほど説明しました。 ここからが本題です。どんな業務の特性や構造があると生成AIエージェントを活かしやすいかを紹介します。
1) 課題はある程度明確だが、答えが一意でない
解決策が複数ありえて、最終的には何らかのアウトプットに落とし込む必要がある業務です。
例)新規プロジェクトの企画立案、製品のデザイン案作成、市場調査からの新サービスアイデア創出
生成AIエージェントは、複数の候補をブラッシュアップしながら比較検討するプロセスを自動で行えるため、こうしたアイデア創出フェーズで特に強みが発揮されます。
2) 業務成果物のバリエーションが多く、都度カスタマイズが必要
業務成果物(レポート、提案書、仕様書など)がテンプレート一辺倒でなく、毎回異なる要望や形式に合わせる必要がある業務です。
例)顧客ごとに異なる用途・要求に合わせて営業資料の作り変え
従来は各種パターンを学習させるのにコストがかかりましたが、生成AIエージェントであれば、ヒアリングした要求をもとに過去の事例を参照しながら文章構成をすぐに生成可能です。汎用性の高さを活かし、都度のカスタマイズやバリエーションに対応できます。
3) 業務の中に複数ツール・データソースを利用する
エージェントが外部ツールを呼び出しながらタスクを進める必要がある業務プロセスです。
例)データ分析ツールを使って売上予測→結果から見込客リストを生成→メール自動送信ツールで一斉連絡
生成AIエージェントはAPI連携やRPAのようなツール利用を組み合わせてタスクを完了できるため、マルチツールを活用したクロスオペレーションでメリットを得やすいです。
エージェントが、「どのツールをいつ、どのように活用すべきか」を自律的に判断しつつ、結果を評価し再度計画をアップデートすることが強みになります。
注意が必要で、先ほどのタスクの抽象度の話のように、特定のプロセスのためだけに作る場合は事前定義のワークフローになってしまいます。数あるユーザーの依頼の一つが例に挙げたオペレーションだったという理解が正しい認識の一つです。
4) “試行錯誤”や“自己改善”が不可欠なPDCAサイクル
PDCAなどの反復的な改善プロセスを通じてブラッシュアップしていく業務です。
例)A/Bテストを繰り返すマーケティング施策、顧客問い合わせに応じたFAQ自動生成、市場調査やSNSトレンドを参照しつつ複数のビジネスモデルを検討した新規事業アイデアの創出 、実験や研究の自動化
計画→実行→結果評価→修正というPDCAサイクルを生成AIエージェントが回します。
5) 情報収集・要約・分類といったナレッジワークが多い
ドキュメントやテキストベースでの大量情報を分析・要約し、次のアクションを提案する業務
例)膨大な社内文書や市場レポートを読み込み、要約や重要ポイントの抽出、既存ナレッジの更新
- 問い合わせ履歴・FAQ・製品マニュアルを横断的に照合し、回答テンプレートを自動生成→異なる問い合わせにも応用
- 膨大なレポート・議事録・特許文献などを読み込み、要点をまとめて各部署へ最適な情報を配信
- 消費者の声やトレンドをエージェントが要約し、次のキャンペーン施策を提案
単なる要約に留まらず、要約した情報を踏まえて実際のアクション(メール送付、提案書生成など)まで繋げられるのがエージェント活用の強み。
6) ルーチンワークだが例外が多く、対応ルールが複雑
ルーチン化はしていても、ルールや条件分岐が多く、作業手順がやや複雑なプロセスを持つ業務です。
例)契約書のチェックフロー、与信審査や請求処理のフロー、在庫データ更新と発注連携
- 契約書チェックフロー: テンプレートはあるが、案件によって特約や法令準拠条項が違うため、エージェントが文章を解析し修正点を提案
- 在庫管理と発注: 商品カテゴリごとに在庫基準が異なり、季節変動やキャンペーンに合わせて発注判断が変わる
シンプルな自動化で対応できる範囲を超えて、イレギュラー対応や例外判断が求められるケースです。
完全に固定化されたフローではRPAが適任ですが、複数の条件分岐や例外的処理がしばしば発生する場合は、エージェントがルールを“言語的に”理解し動的対応できます。
7) 複数ステークホルダーがレビュー/承認し合うワークフロー
業務成果物に複数の意見をもらったり、承認されるまでに様々な役職のレビューが存在する業務です。
例)営業や上長による提案書レビュー、エンジニアやビジネスチームによる仕様書レビュー、人事や法務、総務による規程更新、広報記事
レビューのある業務はエージェントの自己修正の観点に採用されやすく、エージェントらしさが眠っています。
ロールプレイング形式で、「ユーザー視点」「開発視点」「経営視点」などの複数エージェントが、それぞれが意見を出すことで、提出前の段階でさまざまな観点での指摘をまとめた改善ができます。
ここまで紹介してどうでしょうか。自社の業務や相談された中で該当しそうなものはあったでしょうか。
逆に刺さらない業務の特徴とは
一方、生成AIエージェントの強みを活かしにくい、あるいはリスクが大きい業務も存在します。 ここではその典型例を挙げ、導入を慎重に検討すべきケースを解説します。
1) 完全な定型作業やルールベースで完結する
明確なルールと定型的な手順さえ守れば、ほぼ自動化が完成するような業務です。例えば、請求書発行システムから金額をコピーして会計システムにペーストするフォーマット変換作業など極めてシンプルな繰り返し作業や受領メールに添付されたPDFを毎回決まったフォルダに保存するようなデータ移行する作業です。
2) エラーが一切許されないミッション・クリティカルな領域
極めて高い信頼性が求められる業務です。 例えば、振込間違いが起きれば大きな損失や社会的混乱を招く金融機関の基幹決済システムや運行ダイヤに誤差が出ると大規模な混乱に繋がる航空・鉄道の運行管理などです。 厳密なルールと制御が必要な業務には不向きです。 エージェントはおろっと失敗したり、行動の積み重ねはエラーの重ね合わせになりかねないので、失敗がある程度許容される必要があります。
3) 人間の感覚の言語化が難しい
例えば製造現場の物の肌触りや反響音から判断する熟練技能や、ユーザーの生の反応をリアルタイムで感じ取る接客や面接など、五感に依存する業務です。熟練技能も数値化や言語化を進めなければ始まらず、表情や声色も動画像と音声指示で理解できるように見えますが、日本人は表情や態度に感情が現れにくいので、会話の流れの感覚的な空気感を理解するのはチャレンジングです。
4) ゴールがまったく定まっておらず、評価基準自体が存在しない
目的や指標が不確定で、成功条件が全く設定されていないプロジェクトのように「なんとなく新しいことをしてほしい」「大枠は自由でいい」と言われ、評価軸もないケースです。 LLMは目標や質問内容に対して応答する仕組みのため、“成功の定義”がないと試行錯誤がループしてしまう可能性があります。
まとめ
生成AIエージェントは「タスクを自分で考え、外部ツールを使って実行し、結果を見て再計画する」という存在です。 一方でどこでも導入すればよいわけではなく、業務の抽象度や複雑性、イレギュラー対応の度合い、ツール連携の必要性などを見極める必要があります。
生成AIエージェントは、明確なゴールに向かいつつ複数の解や手順があり得る業務や、外部ツールを組み合わせてPDCAを回す必要がある業務で特に効果を発揮します。
DX推進や新規事業開発の現場でも、2025年ますますエージェント活用が加速するはずです。ここで挙げた要点が“課題を探すきっかけ”になれば幸いです。エージェントの強みを活かした本格的なビジネス変革、来年ぜひチャレンジしてみてください。
採用以外でAIエージェントの相談があれば、X( https://x.com/ottamm_190 )にDMして頂ければ可能な限り対応します!
AIエージェントビジネスの現状と今後の考察
こんにちは!年末記事の第二弾、AIエージェントに関するビジネス記事になります。 現状のエージェントはどうなっているのか、今後エージェントを始める方が参考になるように説明します。
第一弾の記事は既に公開されています。
Weekly AI Agent News!から見えたAIエージェントの現在地 - 襖からキリン
私が公開しているWeekly AI Agent News!や論文のリポジトリはこちらです。
AIエージェントに取り組む人材とは?
記事のターゲット層を絞るためにAIエージェントに関わる人材の関係図を示します。
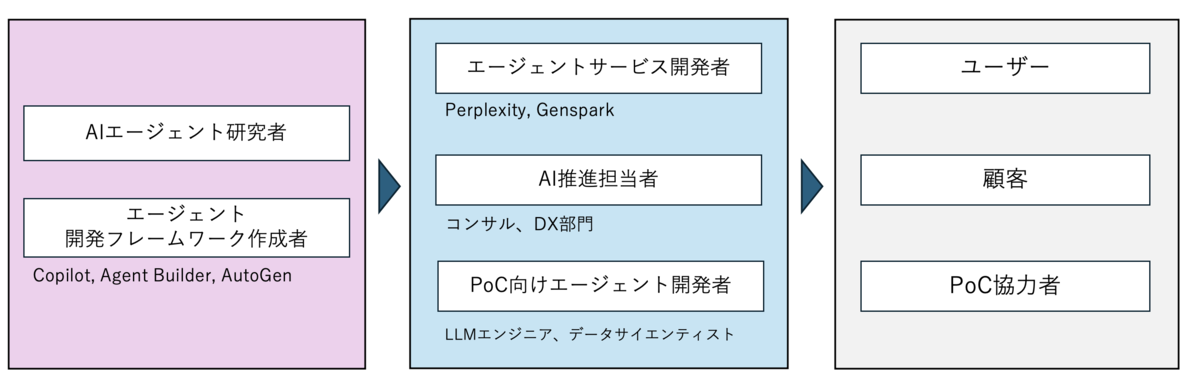
今回の記事のターゲットは真ん中の層になります。
企業のAIエージェントの状況
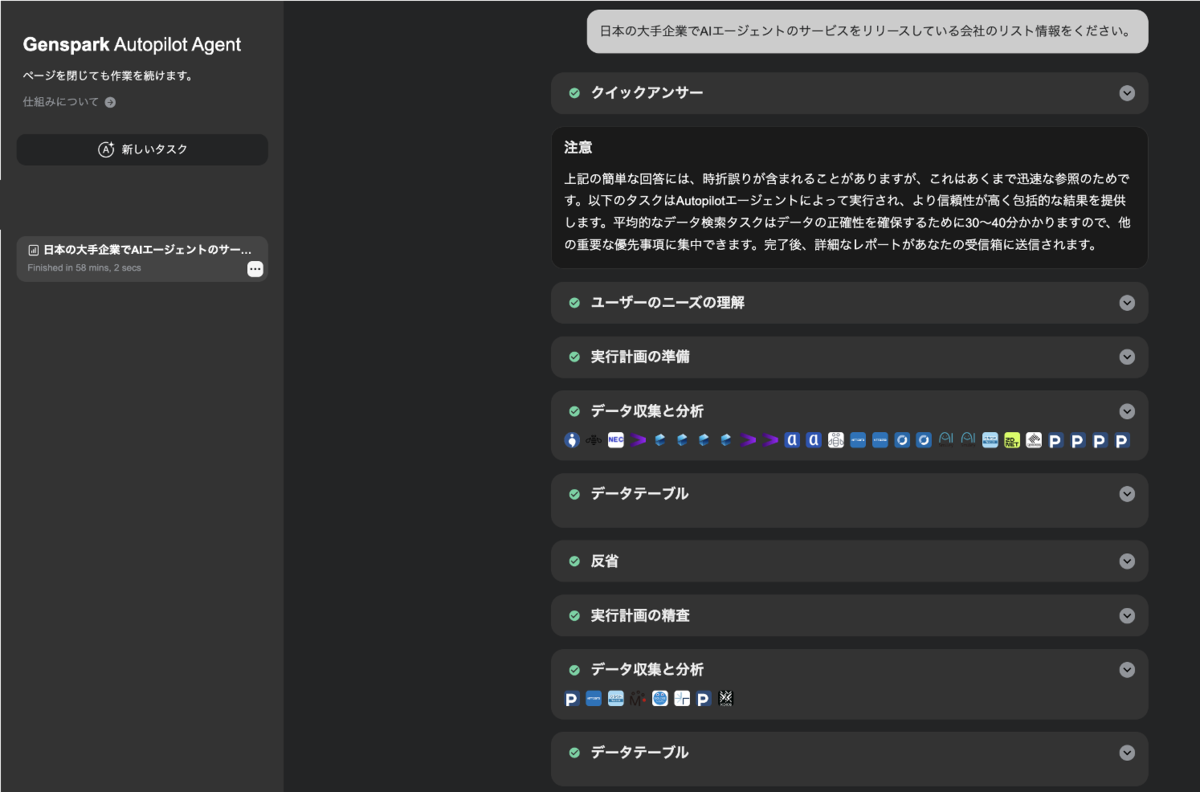
まず最初に国内外のエージェントのサービス状況を振り返ってみます。 以下は大企業を中心にエージェントのサービスを出している、または来年1月からサービスを出す会社です。
国外企業
- Vertex AI Agent Builder release notes | Google Cloud
- AI エージェント — Amazon Bedrock のエージェント — AWS
- Copilot のカスタマイズとエージェントの作成 | Microsoft Copilot Studio
- AIエージェント・ソリューション | IBM
- オラクル、AIエージェントにより、新たな水準で組織の生産性向上を支援 | Oracle 日本
- Agentforceの内側:職場を一変させるAIエージェントの構築 - Salesforce
- Box、AIエージェントをノーコードで作成・展開できる「Box AI Studio」など発表|EnterpriseZine(エンタープライズジン)
- Atlassian Rovoの一般提供開始:人間とAIとの協働で組織の生産性を最大化 | Atlassian Japan 公式ブログ | アトラシアン株式会社
- SAP | Joule のコラボレーティブな AI エージェント
- AI Agents - ServiceNow
- Introducing the new Hiring Assistant for Recruiter & Jobs.
- アクセンチュア、社員と一緒に仕事をこなすAIエージェントを2025年春に全社員へ展開 | IT Leaders
- UiPath、エージェンティックオートメーションを活用する未来の新しいビジョンや戦略を発表
- Snowflake - Snowflake Unveils Snowflake Intelligence: The Future of Data Agents for Enterprise AI
- Mosaic AI Agent Framework | Databricks
- Perplexity
- Genspark Autopilot Agent
国内企業
- ソフトバンク、生成AIエージェント「satto」のベータ版を提供開始~限定先行ユーザーを8月23日から募集開始~ | 企業・IR | ソフトバンク
- AIエージェントの構築支援サービスを開始(2024年10月17日) | CTC - 伊藤忠テクノソリューションズ
- AIエージェントを活用した新たな生成AIサービスを提供開始 | NTTデータグループ - NTT DATA GROUP
- AIが人と協調して自律的に高度な業務を推進する「Fujitsu Kozuchi AI Agent」を提供開始 : 富士通
- SCSKがERP「ProActive」刷新、3種類の生成AIエージェントがデータ分析支援 | 日経クロステック(xTECH)
- NEC、高度な専門業務の自動化により生産性向上を実現するAIエージェントを提供開始 (2024年11月27日): プレスリリース | NEC
クラウドベンダー、ITベンダー、業務支援クラウドサービス、データ分析基盤サービスからエージェントの提供が始まっています。 クラウドベンダーはどこもAgent Builderのようにエージェントを簡単に作れる開発フレームワークの提供をしています。
それ以外は各社のサービスの強みを活かしたエージェントを提供しています。 データ基盤ならデータ分析支援、ドキュメント管理なら質問応答、業務支援ならタスク代行という形です。
既存サービスがない場合は、Web検索に基づくリサーチ支援サービス、エージェント開発伴奏、営業等の資料作成支援サービスを提供しています。
現状の主力エージェント製品を解説
エージェントビルダー
エージェント開発が難しいユーザー層にプロバイダが開発済みのエージェントを提供する、またはその一部カスタマイズできるサービスです。 AWS, Google, Microsoft等主要なクラウドベンダーはこぞって出しています。
具体的にどの業務で使うのが有効かなどの明確なユースケースは、私が知る限りではありません。 ただ様々な顧客の業務課題ごとに調節できるように様々なアプリやデータと連携できます。
この手のエージェント開発は連携先アプリの機能が重要で、連携先アプリを人を介さずコントロールするのがエージェントの役割になります。 ただ、作ったエージェントがどれだけ日常的に使ってもらえるか、業務改善のインパクトを出せるかはこれからです。
エージェントにメールの文面を考えさせて一時保存させたり、採用面接の担当者を割り当てたりと細かいタスクをやらせるか、大勢が共通の課題を持つタスクを担わせるかは考えものです。
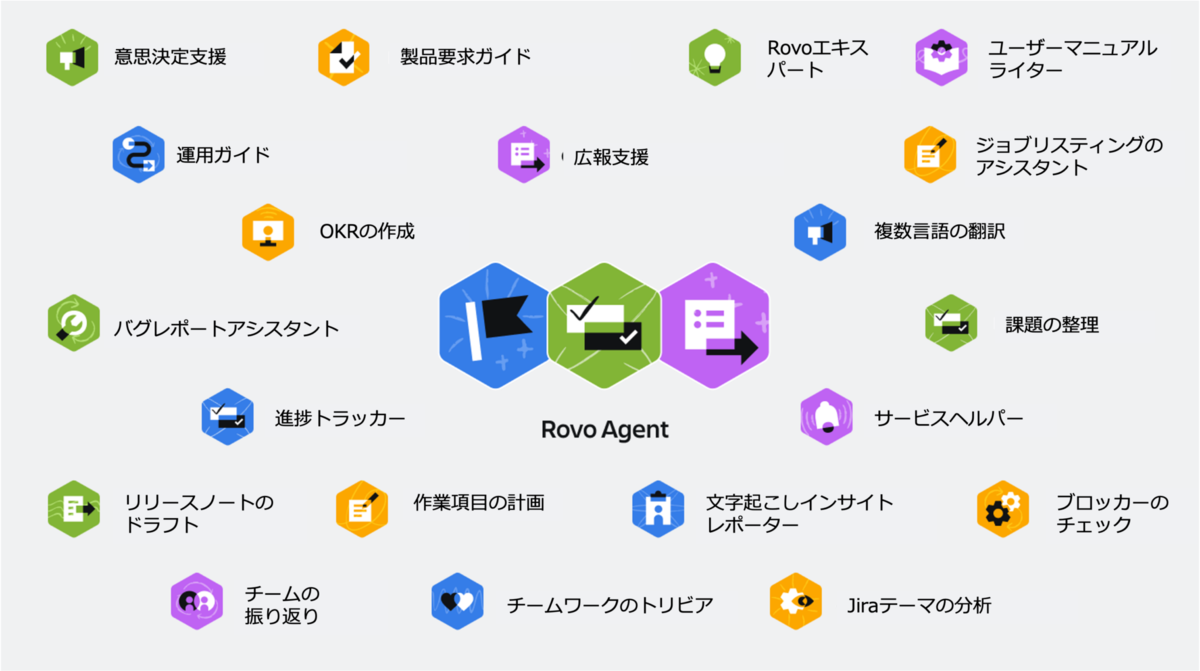
このビジネスの火付け役はやはりOpenAIのGPTsになります。
リサーチ、問い合わせ対応
RAGの延長線上のビジネスです。情報検索は社内文書やWeb情報を含みます。 このエージェントはドキュメント管理サービス会社やRAGソリューション提供会社から提供されています。
Web検索はリサーチ業務で使われ、社内文書の検索は問い合わせ業務で使われます。 リサーチは価格比較、特許検索、競合分析などに使用します。
エージェントの情報検索では必要な情報が揃うまで繰り返し検索をおこないます。そして、エージェントが必要な情報が揃ったか、もう揃わないか判断します。(その基準の定義が難しいことはやっている人は分かります。)
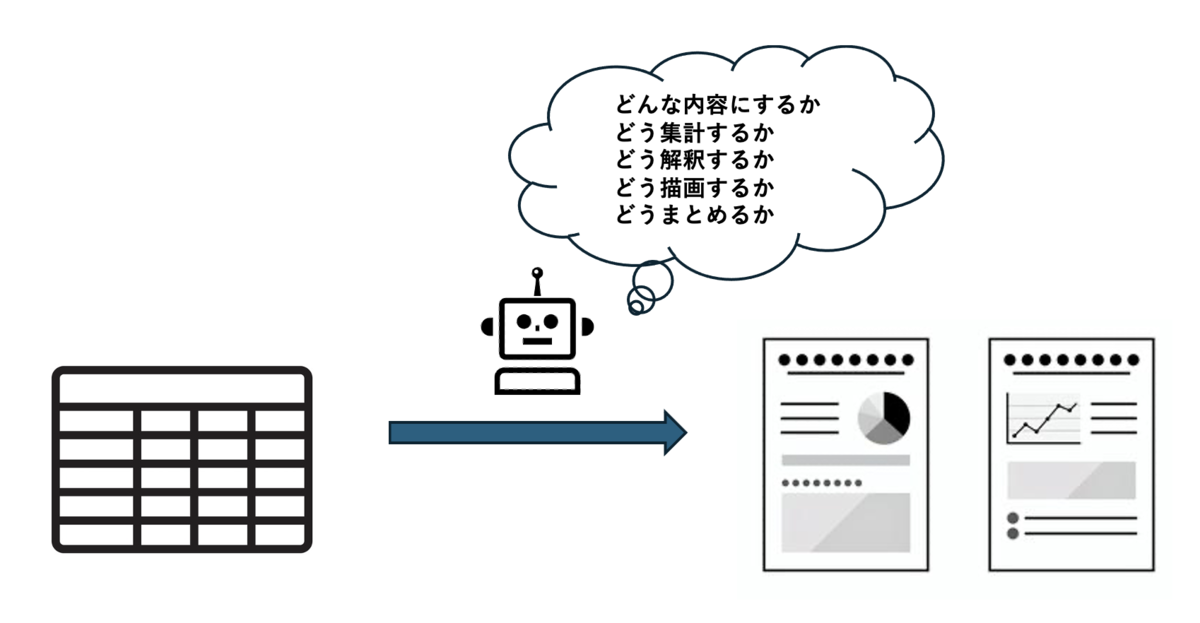
データに基づく意思決定支援
売り上げデータやCRMのデータを必要に応じて読み取り、分析してグラフなどに可視化して意思決定材料を報告します。 このエージェントはデータ分析基盤や基幹システムを提供する会社から提供されています。
分析プロセスは目的やデータに応じて変化するため、固定されたワークフローではなく、エージェントが考える必要があります。
様々なソースから資料作成
資料作成は提案書、調査報告書、事例資料、ブログ、プレスリリースなど様々です。 エージェントがWeb調査したり、社内資料を探し、データを読み取りしながら最後のレポートにまとめます。 このエージェントはシンクタンク、コンサル、ITベンダーから提供されています。
どんな資料を作るかによって体裁や調査方法、読み解くデータが異なるため、定まったワークフローにならず、エージェントが考える必要があります。もっと特化型にするならば、作成する資料単位でエージェントを作ります。

Agentic Process Automation
RPA(Robotic Process Automation)の拡張になります。RPAは定型業務を自動化するフローをノーコードで作っていました。 ただし、作った自動化フローのメンテナンスが度々必要でゾンビロボットが増えることもあり、ノーコードを使いこなす人材の育成も必要でした。 Agentic Process Automationはエージェントが定型業務と非定型業務のワークフローを作ってくれます。
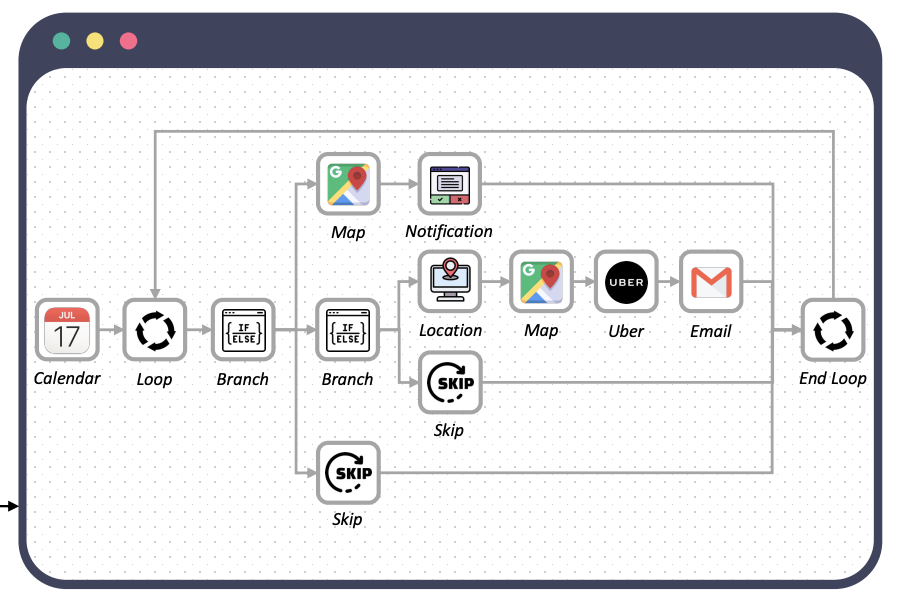
これからのエージェントを考える
生成AIエージェントと業務ソフトウェアの結びつきが強くなる
多くのソフトウェアに「xx Intelligence」や「xx Agent」と名付けた機能がこれから徐々に増えていきます。 現状はAIの強い会社が様々なプラットフォームに繋ぐ口を作り、データ連携を強化しています。 データ連携先が増えればそれだけユーザーの利用用途を模索でき、ビジネスチャンスが生まれるからです。
一方で、私はSalesforceのように自社サービスの強みを活かした機能が増えていくと考えています。 現にテキスト指示だけでソフトウェアを制御し、シミュレーションをおこなうなどの研究は増えつつあります。 以下にも研究の実例を紹介しています。
Weekly AI Agent News!から見えたAIエージェントの現在地 - 襖からキリン
結局、エージェントの精度を高めるためには領域を絞り込み、タスクを限定させ、作り込む必要があります。 なんでもデータ連携できても、結局一つ一つの精度が出ないとユーザーは使わなくなります。
あなたがエージェントビルダーを使うユーザーになる前に、自社のサービスを見直す方が賢明かもしれません。
「ユーザーが指示するだけで〇〇の業務が完了/効率化する」がキャッチコピーになる
マーケティングでこのフレーズを見ることが増えてきていますが、さらに増えると考えています。 UIで詳細設定まで細かく設定したり、パソコンの前で何度も手順書を見てやっていたことが、テキストや音声で指示をするだけで実行できると謳うソリューションです。
理由は、カスタムエージェントを提供する会社は売り文句がカスタマイズ性と自動化とデータ連携性に集まり、作ったエージェントのデプロイ先がTeamsやslackなどのコミニケーションツールかChatGPTのWeb版のようになるためです。
その結果、対話形式で様々なタスクが自動化されると表現されます。
業務特化のエージェントも同様で、どの業務が完了するかを変えるだけで同じ謳い文句になります。
GUIからコンピュータを制御するのはまだ難しい
研究テーマとして非常に難易度が高く人気がありますが、ビジネスで利用するにはまだ厳しい見方をしています。 コンピュータ制御でWebナビゲーションをするにしても、様々なサイトへの適応力やアプリの使い方の理解、画面に存在する数多くのボタンの意味を的確に理解し実行する必要があります。しかもそれらを的確に10回以上正しく続けて初めてECサイトの購入などのタスクは完了します。
LLMプロバイダは稼ぐ必要があり、APIの利用料は痩せ細ったため、アプリケーションで稼ぐ必要があります。 そのためのアプリケーションとして先行者利益でAnthropicは、Computer Useの機能を出していますが、まだ成就するのに時間がかかります。
Computer use (beta) - Anthropic
Appleのようなスマホを提供する会社もエージェントによる音声アプリ操作は力を入れています。 しかし、まだ人間が望むような高い汎用性は研究では得られていません。
汎用的なエージェント設計は難しく、業務特化のエージェントに勝機あり
エージェントを汎用的に複数の業務で役立つようにすると図に示すようなアーキテクチャになりますが、各業務の精度は単体特化より下がってしまうことが経験的に知られています(左下)。 全てを高い精度で維持するには、エージェントのアーキテクチャの工夫よりも、ベースとなるLLMの能力の向上が今以上に必須です。
精度が低いとユーザーは使いませんし、納品すらできません。結局、業務特化で動くように作ることになります(上段)。
そして、業務特化のエージェントをいくつも作り、オーケストレーターがルーティングして、あたかも汎用的なエージェントに見せかける(右下)のが今の技術の現状です。
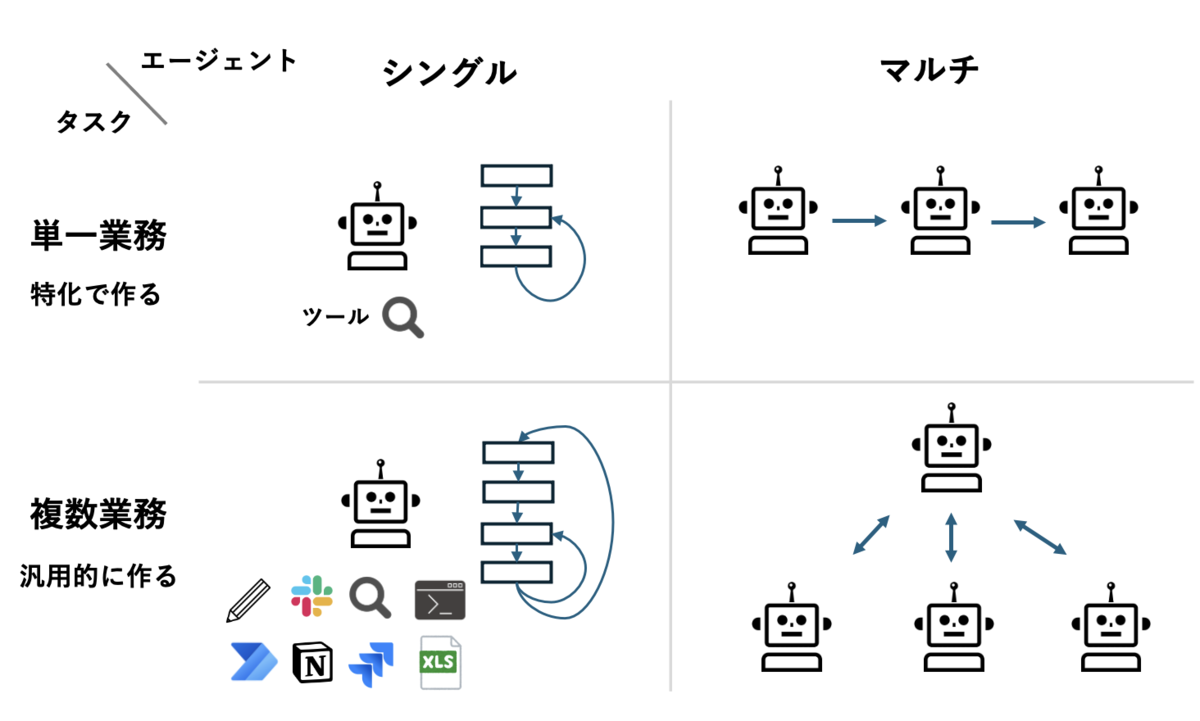
既に海外のベンチャーは去年の時点で汎用型で失敗し、特化型でビジネスを進めています。 以下の記事は今年の6月の記事ですが、その背景が良くわかるのでおすすめです。
Agents aren’t all you need - by Miguel Rios Berrios
AIエージェントの誤解
自動化したければAIエージェントではない
最近のリリースや発表を見ると、研究者が目指すエージェントとビジネスで使うエージェントに乖離が出ています。
ビジネスの方が定義が緩く、とにかくバズワードを使いたいと言わんばかりに内部ロジックや振る舞いに限らず、AIを使って自動化したものは全てエージェントとしている印象です。 超大手の某社は通訳するだけでエージェントという始末。
研究のツール利用、メモリ、計画などを軸にしたLLMエージェントを知っている人からすると、最近の某社リリース内容はエージェントではないと言いたくなるものです。 ですが、それ以前にもエージェントの概念はもちろんあり、人工知能が環境で動作するならその主体はエージェントと考えることもできます(Russell and Norvig, 2022)。 今までもエージェントの概念はあって、少しずつ時代に合わせて変化していきます。
あなたは広義のエージェントか最近の狭意のエージェントのどちらで語っていますか。 マーケティング観点では広義の方が使いやすく、技術者の場合、狭意の方が技術的に議論がしやすく分かりやすいでしょう。
なぜこんなにも命名に慎重なのかというと、研究者が現在目指す”エージェント”が適切に刺さる課題は、世の人が自動化したいことの一部です。(ほんの一部は言い過ぎな気もしたので期待を込めて一部です。) むしろ自動化したいことの多くは別の方法で解決する方が性能が良いです。広義でエージェントで考えているとその違いを区別できず、見えなくなってしまいます。
私の体感では以下の図のイメージです。以下は全て狭義のLLMエージェントのことを指しています。
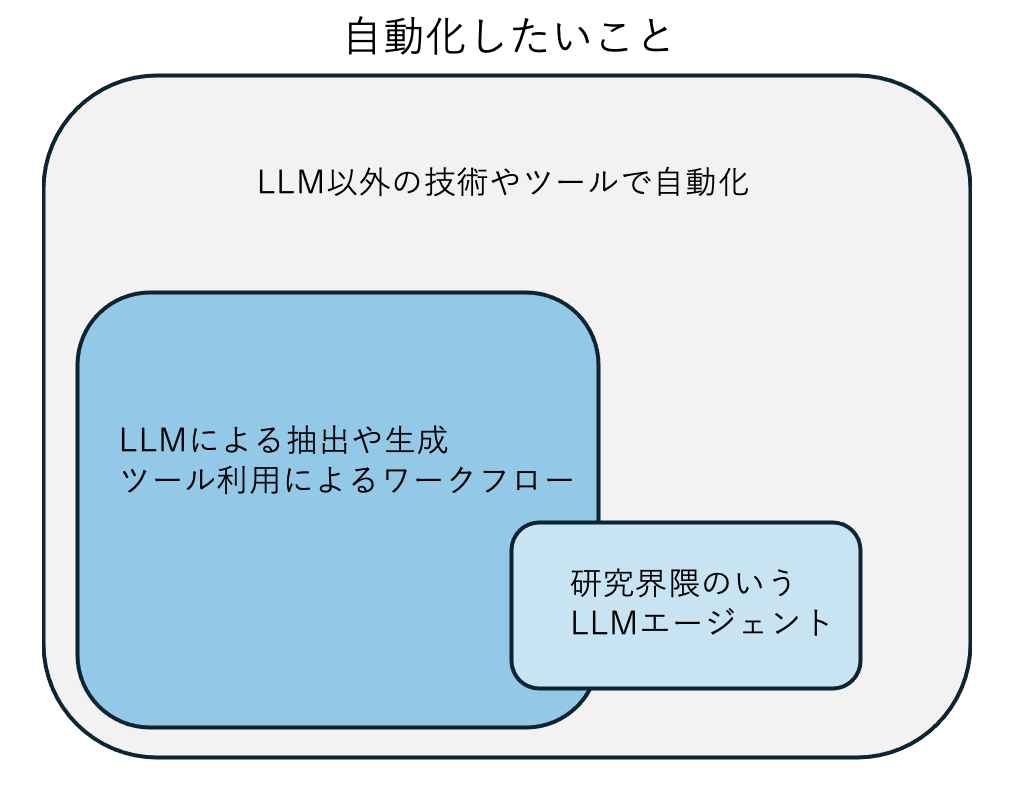
わざわざLLMがツールを使わずとも既に世の中には便利なツールがあります。それだけで解決できるかもしれません。 社内から「エージェントでもできるけど、別のツールでもできるよね?」と声が上がると良いですね。
更に自動化したいことのうち、LLMを使うことが有効そうな課題はその一部で、検索含めたLLMによるワークフローで解決を目指せます。 わざわざ思考して計画立てたり、自己修正もいらないです。淡々と上から下に処理を流して、プロンプトエンジニアリングすれば良いです。 ただ最近はこのフローの処理一つ一つをエージェントと呼び、マルチエージェント呼ぶ人たちもいます。
エージェントは、タスクの処理プロセスが動的であったり、人間のような思考でケースバイケースを対処する必要がある課題に対して出番になります。
なんでもかんでもエージェントに持っていくことはできますが、果たしてそれが最適な解法なのかは注意深く検討する必要があります。 過去のDeepでぽん!だった時代を思い出すとわかってくれる人はいると思います。
エージェントのプロセスが理にかなっているから結果も正しいわけではない
エージェントの動作の仕組みが、人間の業務フローと似て納得感があれば、結果が正しくて業務に役にたつように思ってしまいますが、そんな保証は全くないです。 いくらエージェントのフローが人間の解釈的に妥当でも、プロンプトが妥当でも、LLMが正しく出力できなければ、それで処理は終わりです。
エージェントに複雑なことをさせているため、結果で良さが測りにくくなり、いつの間にか結果重視からプロセス重視になっていませんか。 エージェントの動作原理の説明は、あくまで顧客にサービスの透明性と信頼性の補助材料であって本質は結果です。
できる限り、そのエージェントがどんな課題にどう答えることができるのか、プロセス評価と合わせて結果も評価し、アピールすべきです。 単純なLLMの生成やRAGより良い回答をするとか、回答に深みが出るでは足りません。
来年には似たようなエージェントが市場に乱立します。そのとき他社と比較されたとき説明できますか。 そのためには結果にこだわり、アピールポイントを端的に説明できるようににこだわる必要があります。
似たような話で、OpenAIのo1から推論スケーリング則でプロセス評価が注目されていますが、結果の教師でなくプロセスを監督する必要性という記事が過去にあります。こちらもおすすめの記事です。
Supervise Process, not Outcomes — AI Alignment Forum
都合のいい言葉「マルチエージェント」
そもそもマルチエージェントのエージェントをどう解釈していますか。ここが大事です。 人の職業や性格などの役割を指すのか、タスク処理の機能を指すのか、自律型エージェントを指すのかです。
強化学習では、意思決定モデルをエージェントと呼びます。もちろんマルチエージェント強化学習のエージェントでも同じです。
ただLLM以降の生成AIエージェントでは同時期に様々な分野から多くの論文が発表され、エージェントの言葉がそれぞれの分野の意図でそのまま使われました。例えば、分野としては社会シミュレーション、ゲーム理論、心理学、対話システム、MAS、強化学習、ツール利用があります。
その結果、新たな流派のLLMエージェントとそのマルチ化のマルチエージェントという構図にはなりませんでした。
どれが間違いということでもないので、せめて自社の目指すエージェント像のマルチ化をマルチエージェントとして統一してほしいですね。
でないとあなたの会社が言うところのエージェントってなんですか?でサービスの内容と矛盾を生み、混乱になります。下手したらどれもこれもエージェントでは?と指摘されかねます。営業が顧客に説明するときに苦労するのが目に見えます。
そしてエージェントの命名が適当になってくると、「なんだエージェントって大した事ないのね。」ということになり、一瞬で幻滅期に突入すると考えます。
最後に
この記事では、エージェントの現状のビジネスを振り返り、これからエージェントのビジネスがどうなるか、更にエージェントに関して良くある誤解をまとめました。
- エージェントビジネスはまだ黎明期であり、多くの課題を抱えます。
- 自社のサービスと市場ニーズに合った特化型エージェント開発が鍵です。
- 技術者とビジネス層が連携して戦略を練る必要があります。
この記事を読んで、ぜひ自社のエージェント開発を振り返ったり、来年の戦略を考えてみてください。
Weekly AI Agent News!から見えたAIエージェントの現在地
こんにちは!もう12月ということで一年の締めくくりの記事を書きます。 第一弾ではWeekly AI Agent News!を4月から更新し続けた学びを書きます。 様々なエージェントの論文から技術的な気づきとWeekly AI Agents News!を更新し続けて良かったことをそれぞれ紹介します。
第二弾の記事は、AIエージェントのビジネスの現状と今後の考察です。
こちらも是非!
AIエージェントビジネスの現状と今後の考察 - 襖からキリン
weekly AI Agents News! は私が会社と関係なく個人的に始めたエージェントに関する論文やニュースをまとめた資料です。 4月から2週に1度更新をしており、AIのビジネスを考える層やエージェントを開発するLLMエンジニア層、AI研究者層をターゲットに情報を発信しています。 過去のものアーカイブされています。
最近リポジトリでも論文を整理しました。併せてご覧ください!
なぜ資料の更新をしていたのか
直接的な金銭をもらっているわけでもなく、なぜ無料で継続して更新していたのかを説明します。 一番は自分の学びのためです。その次にエージェントの面白さを1人でも多くの方に知ってほしいという思いです。
まずエージェントは設計からチューニングまで面白いです。 エージェントはLLM単体で完結せず、業務アプリやシステムとAPIやコード経由で接続し、実行履歴をメモリで管理しながらタスクを実行します。 人間のためのソフトウェアやシステム、ドキュメントをAIが活用して問題解決するのは今までにないエージェントの醍醐味です。 そして、なるべく多くの問題解決をできるようにAIの思考回路を汎用的に作り込むのは難しくもAGIへの道となり、エンジニアリングが非常にものを言います。 人間ならどう考え、新人ならベテランならどうするか、合理的に考えればどうあるべきか、と考えながらエージェントの思考回路を作るのはやりがいの一つです。
今までの微調整したモデルをAPIにして継続的に改善していくのも十分楽しいですが、よりガチャガチャとパーツを組み替えながら作っていくエージェント開発が私は楽しいです。 余談ですが、エージェントは大学の研究室より企業の方が取り組みやすく相性は良いと考えています。企業は様々なソリューションを持ち、独自データがあります。 これらを活用したエージェントがどのような顧客体験を提供できるのか考え、PoCをするのはワクワクしますね。
そんなエージェントの面白さを1人でも多くの人に知ってもらいたく発信を始めました。発信を始めた2024年春頃はRAGかLLM開発が世間の注目を集めていたと認識しています。 国内の優秀な方はLLMの開発に取り組まれ、LLMを応用したエージェントを開発する人材は少なく、会社外で議論できる人が少なかったです。(取り組んでそうな方とはDMして直接会話してました。) また私が社内でエージェントを取り組んでいても、自部署と私と対話した顧客くらいにしかエージェントの面白さが伝わりません。 多くの方がエージェントに興味を持って国内でエージェントの取り組みが増えて盛り上がれば嬉しいくらいの気持ちで始めました。(と言いつつビッグテック企業がエージェントをリリースし始めれば日本の企業も後追いするのはほぼ自明なので、先に技術に明るい人に伝わればいいのと、後追いする人の知の高速道路になればいいなという気持ちもありました。)
そのため、発信する内容には論文では応用面と基礎面を分けました。結局、エージェントの応用先が金になりそうでなければ誰も取り組まないので、どんな応用があるのかは大事です。 そして、基礎面では応用があっても精度が低ければ意味がないので、エージェントの基礎技術の精度向上方法やその精度をまとめました。 プロダクトやニュースではベンチャーのプロダクトにコンサルやブログなど様々な媒体でエージェントに関するものを集め動向を注視しできるようにしました。
技術的に気づいたこと3選
1) マクロレベルでエージェントアーキテクチャに差分はない
昨今のLLMを用いたエージェントは登場から2年近く経っていますが、2024年に何か新しいエージェントの基礎技術があったかといわれると言葉が詰まります。 エージェントの基礎は2023年の夏には出揃っていたと思います。 エージェントの基礎は、知覚、プロフィール、プランニング、リフレクション、ツール利用、メモリです。 各大学や企業が様々なエージェントアーキテクチャを提案したのも2024年の特徴ですが、どれも同じ基礎技術を使っています。 もう少し言うと、エージェントアーキテクチャもほぼ同じです。過去の経験をメモリから引き出して、計画して、行動して、振り返って、目標を達成したか確認するプロセスはどのエージェントも同じです。
例えば、ソフトウェアを操作するエージェントを見てみます。
- 一つ目は、流体解析のソフトウェア(OpenFOAM)のチュートリアルや操作コマンドをもとにエージェントが実行する論文です。
- 二つ目は、地理空間情報データ分析のソフトウェア(QGIS)の操作を自動化するエージェントの論文です。
どちらもエージェントのアーキテクチャの根幹は同じです。図を見ると人間の役割をもとに業務プロセスを記述するか、エージェントのワークフローを記述するかの違いです。
ソフトウェアの操作だけでなく、RAGの拡張も、データ分析も文章作成系もマクロレベルでは同様なエージェントアーキテクチャになっていることがほとんどです。
なぜならそれが人間の基本的な思考と行動プロセスだからです。考えて、行動して、振り返って、また考えて、行動する。
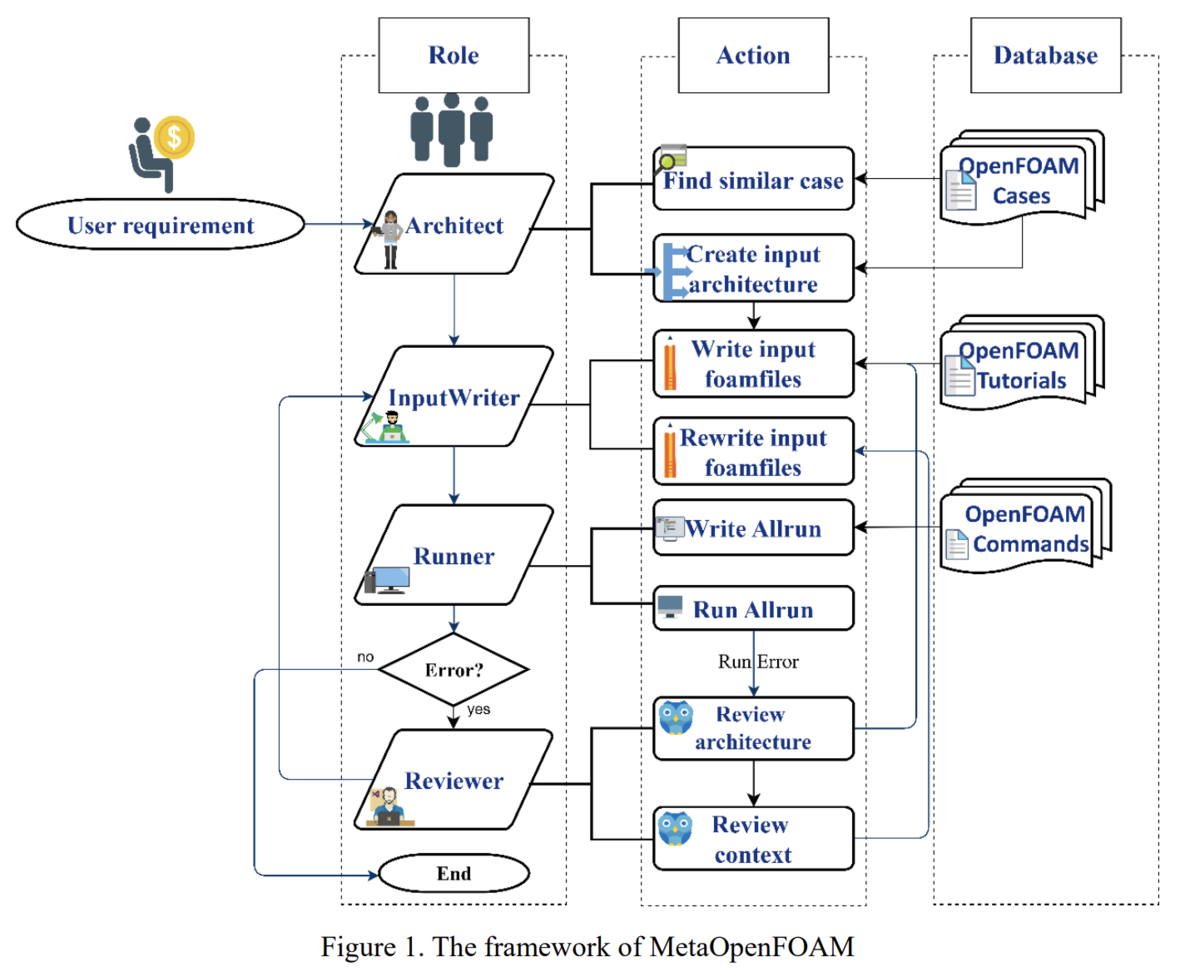
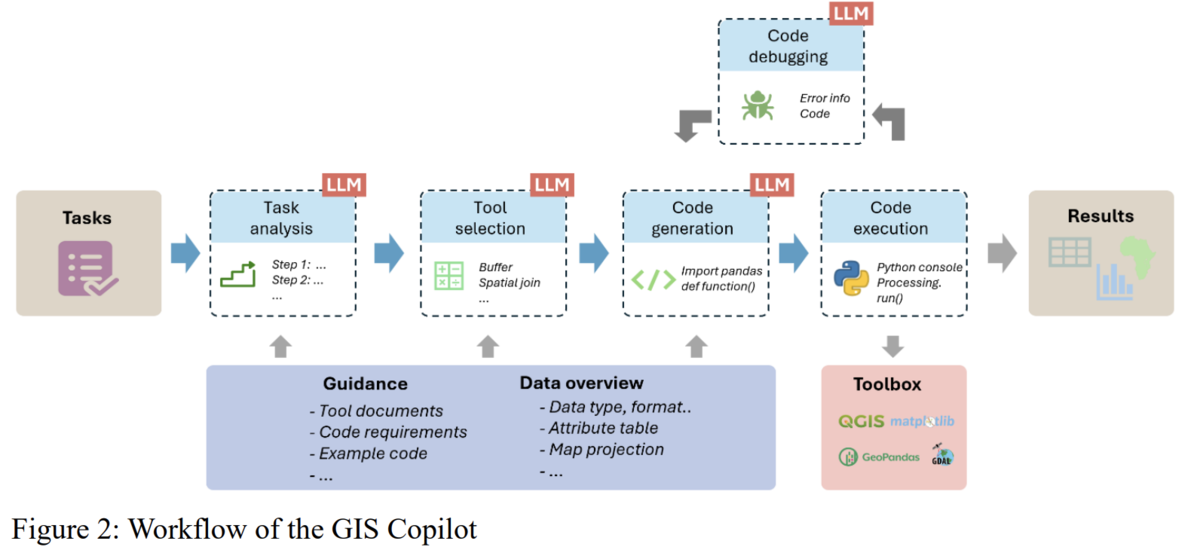
エージェントの細部を作りこむことは怠らない
アーキテクチャに差分がなければ、どこに違いがあって2024年は研究は進んだのでしょうか、または精度に差を出したのでしょうか。 それは問題設定を定義し直すか、エージェントの細部にこだわるかです。
エージェントの細部の一つは基礎モジュールの高度化です。 メモリを作り込むか、ツールを作り込むか、知覚内容を簡潔にするか、プランニングを階層化するか、特定の用途で学習するかなど、基礎部分の高度化で差分を出します。
もう一つの細部はプロンプトエンジニアリングです。 メモリに保存する内容の抽出プロンプトだったり、ツールを選択する基準であったり、プランニングの方向性を縛るプロンプトだったりします。
これらのトレードオフとして、解ける問題が狭まったり、推論時間が増えたり、コストが増えたり、メモリ管理が問題になったりしています。
自社で取り組むエージェント開発に役立ちそうなテクニックを知りたい方は、Weekly AI Agent News!を読んで頂ければと思います。
2) 2024年のAIエージェントは応用の開拓の年だった
応用の開拓の年と思えた一つに2024年は多くのベンチマークが用意されエージェントが評価されました。 ベンチマークのジャンルは応用系だとコンピュータ操作、データ分析&モデリング、リスク評価、ソフトウェア開発です。 またエージェントの個別能力のツール利用力や計画力などを評価するベンチマークも多数ありました。 ベンチマークは徐々に問題設定が現実的になり、オフラインからオンライン評価に変わり、過去のベンチマークを見直す動きがありました。 これらのベンチマークの評価からエージェントの限界や特徴を抑えるのは意味があります。 皆さんが先行研究で明らかになっている課題で躓かないように、ベンチマークの詳細、実験設定と結果、エラー分析は今後も目を通しておくことをお勧めします。
もう一つ応用開拓の年と思えたのは、特定の業務に向けたエージェントを開発し評価した論文が多く発表されたからです。 これらはコンピュータ操作のように多くの企業が競い合って取り組む系統と違い、ニッチな業務でエージェントを開発して適応してみたという研究で、AIコンサルのようなビジネスサイドはそういった論文の方が興味があると思います。 例えば以下のような研究があります。
- Salesforce はCRMの業務を代替するエージェント用のベンチマークを提案しています(Huang, 2024)。Salesforce AI Research はエージェントに力入れてますね。よく論文を見かけます。 自社の強みを活かしてエージェントで顧客体験を改善していくのはどうでしょうか。
- Siemens は製造現場の製造計画やプロセス評価のための3Dモデリングを自動化するエージェントを提案しています(Xia, 2024)。Siemensが提供するTecnomatixのAPIを利用します。 製造業にありがちな複雑なソフトウェアの操作やアイデア出しにつながるのではないでしょうか。
- Microsoftと香港大学はテーブルデータからレポートを作成するエージェントを提案しています(Shen, 2024)。グラフとその説明だけでなく、レポートの読み方のストーリーまで作ります。 レポート作成が多い部署の支援になるのではないでしょうか。
- 教育系だと精華大学らがメンターエージェントを提案しています。(Zha, 2024)。学生が問題発見から情報収集、解決策を考える思考能力を身につくように手助けします。 教育系のビジネスをする方の支援になるのではないでしょうか。


2025年は日本でも多くの企業がエージェントを取り組むと予想されます。 最初はRAGのときと同様で成功しそうな先行事例のある問題設定で取り組み、知見を得るフェーズです。 関係者の知見も溜まれば、次は自社の業務特有の深い課題に挑戦していき、エージェントの応用が業界単位で枝分かれしていくと予想します。
応用を他に知りたい方は私のリポジトリにまとめているのでご覧ください!
GitHub - masamasa59/ai-agent-papers: Weekly AI Agent News!の論文内容を更新
3) エージェントを独自開発して本当に精度は向上しているのか
多くの企業や組織が既存エージェントをカスタマイズするのではなく、エージェントアーキテクチャから開発して、知見を溜めている段階です。 しかし、論文を読む中でエージェントに懐疑的に思うことがあるので共有します。
一つ目は、車輪の再発明とまでは言いませんが、新たに論文で〇〇 Agent を提案しても、結果から明らかになったことも、課題も半年前から分かっていたことで、精度もそこまで改善していないのではないのか。 多くの論文が似たような問題設定で似たようなエージェントを作って、同じ課題にぶつかっていると感じます。 まるでCNNやLSTMの亜種モデルを作っていた頃のようです。 少し違うのはNNモデルのときと違い、個別にエージェントを開発しすぎて正当な比較ができていないのがエージェント界隈の課題です。 エージェントが観測する内容やその前処理方法、行動内容など様々な違いがあり、ベンチマークもそれぞれが作り、比較するのは難しくなっています。 研究での評価は、開発したエージェントのLLMを変えて比較したり、開発したエージェントの一部の機能を取り除いて評価したり、競争力があまりないシンプルなエージェントで比較しているのが実情です。 本当に開発したエージェントは別のより価値があるのか謎になっています。
二つ目は、エージェントの開発に見合う精度がでているのかが疑問です。
LangChainが1300名に取ったアンケートでも、エージェントの精度が重要だと報告されています。

OS Worldのベンチマークで比較をすると精度の高いエージェントで20%台です。20%と数字が低いことは残念ですがそこが問題ではありません。他の最近のエージェント論文でもOSCAR (Wang, 2024)で24.5%、OS-ATLAS (Wu, 2024)で14.63%、LMM単体と比べれば10%程度の改善はありますが、エージェント間ではどんぐりの背比べになっています。 この10%を大幅な改善として見るかは人によりますが、私は開発と保守工数に対して、中々厳しい結果だと受け止めています。 なぜなら従来のNNの損失関数の工夫や層数やアテンション方法と違い、エージェントはマクロレベルではアーキテクチャは似ていますが、細部でLLMの観測内容、行動の選択肢、計画方法と様々な部分で違いを作っています(コード量もプロンプトもそれなりに多い)。 しかし、異なるエージェントとの差、ベースモデルとの差が最終性能で見たときに数%のインパクトしか与えていないということです。
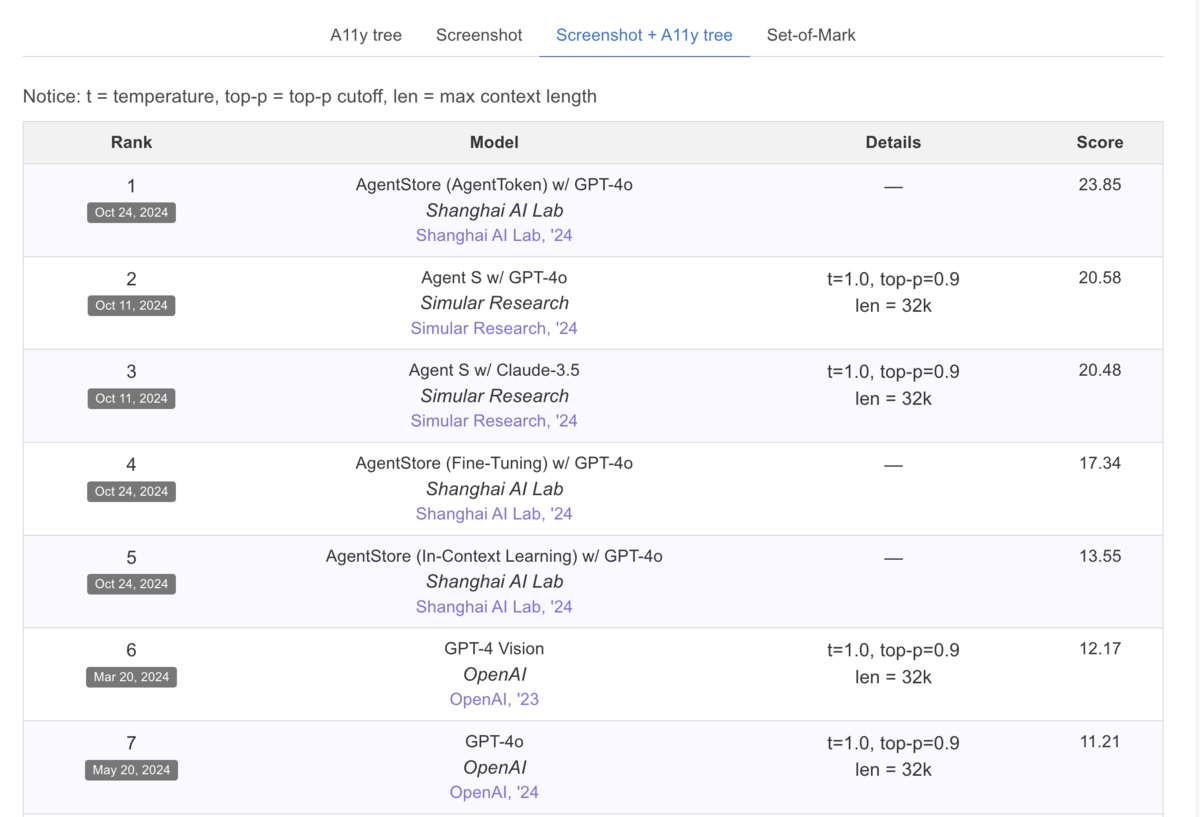
もう一つVisualWebArenaのLeaderboardを見てみます。
ベースのGPT4oからどれだけエージェントの仕組みを入れて精度が向上しているか見てみます。
ここでもエージェントの最高性能でgpt4oに比べ13.92%アップしていますが、それ以外のエージェントたちは数%の改善幅で並んでおり、元のLLMの能力の限界に強く引きづられ、峠を越えるようなインパクトのある結果にはなっていません。
個人的にエージェントになったからにはLLM単体から数メートル先で着地しないでほしいという気持ちがあります。

最後にエージェントアーキテクチャの自動探索の研究結果を見てみます。
複数の初期のエージェントアーキテクチャから改良を加えていく方法ですが、有名なADAS(Hu, 2024) の結果を含めた最新の自動探索手法 AFlowの結果を見てみます(Zhang, 2024)。

単純なgpt4o-miniと比較して、アーキテクチャの自動探索結果は7.5%しか向上していません。ADASに限っては意図的かはさておき、gpt-4o-mini単体より低い結果を示しています。 また有名なプロンプト手法と比較しても、数%の違いしか生み出せていません。 多くの計算資源を投入し、複雑なエージェントアーキテクチャを探索してもそこまでインパクトはないようにも見えます。
他にもメモリを活用した結果の精度向上幅を示している論文を見ます。
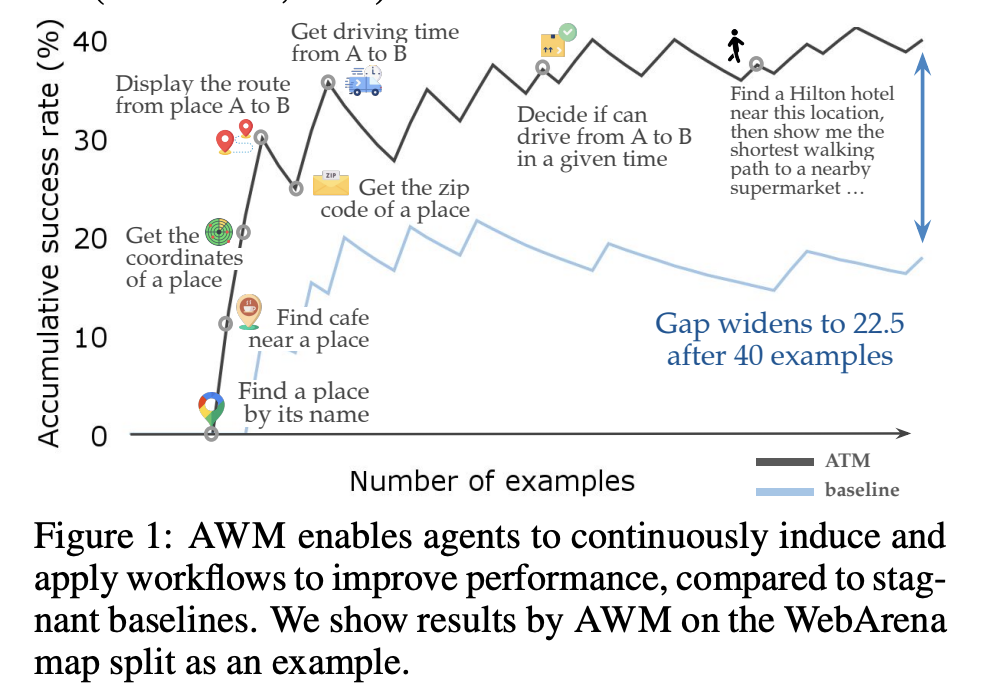
結論を出すのはまだ時期早々かと思いますが、現状だと同じLLMをベースにするとエージェントアーキテクチャに細部までこだわっても性能の改善は横並びか数%の違いで、メモリを使っても継続的に精度が向上しない可能性があり、ベースのLLMの性能アップの影響が大きいと考えます。 正当にエージェントの細部にこだわっても精度が一定以上超えないのは、エージェントの内部でよくあるLLMの能力の限界にぶつかっているからです。 例えば、長期計画が苦手とか、環境の適応力がないとか、Weekly AI Agent News!を読んでいる人なら分かると思います。 ベンチマークは意図して簡単なタスクから難しいタスクがあるので精度が出なくても仕方ありません。 ビジネスではエージェント内部でLLMの能力の限界にギリぶつからない範囲で価値を出しましょう。
エージェントのタスク成功率を高める技術要素は何だろう
以降は私のただの考えです。エビデンスがあるわけでもないです。 今までの機械学習はざっくりデータ、モデル、ハイパラが予測モデルを作る要素でした。 特に“Garbage in , Garbage out”と言われるようにデータの品質が重視され、モデルは初手これだよねというベースモデルが確立されて、あとはハイパラ最適化の世界でした。データが大事と良く語っていたと思います。 今のエージェントはクローズドモデルのLLMの土台があって、環境から観測できることを設計し、エージェントのアーキテクチャを設計し、プロンプトチューニングをおこない、メモリを活用します。
エージェントの場合、精度改善に強く寄与するのはどの要素なのでしょうか。
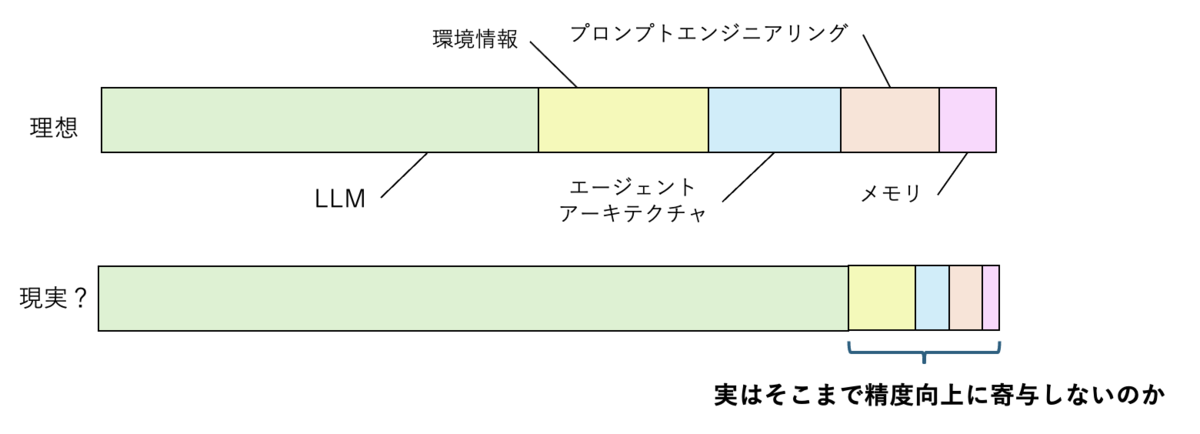
下段のグラフも仮説ですが、自分の感じているところです。 エージェントはLLMの能力に強く依存しており、正当に作り込んだエージェントアーキテクチャとプロンプトであれば、アーキテクチャバイアスはあれど、最終的な精度に影響は小さいのではないかというものです。 Webナビゲーションなどデジタルエージェントに関しては、どのエージェントも工夫は違えど精度が似たり寄ったりな部分で、乱暴に言えば、ベースのLLMの差が最も影響するのではないかと考えています。 そのLLMの差も段々と小さくなってきていますが。。。
私はよくLLM+αと比べ、エージェントにすることで最終回答の品質ってどのくらい良くなるの?と言います。なぜ良くなったのかも言語化させます。ツールを使うことでしか解けないタスクならば、シンプルなエージェントと比較して意味があるのかを考えます。みんさんの体感はどうでしょうか。エージェントのどの要素を改善していくことが必要だと思いますか。
機械学習のパラダイムにエージェントを照らし合わせて考える
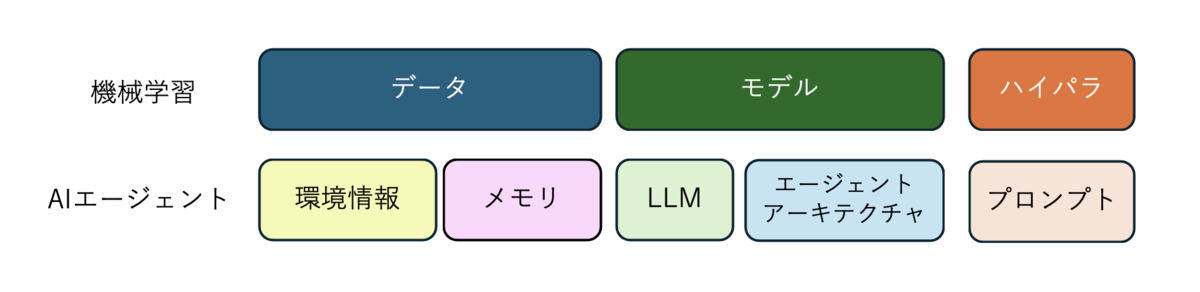
精度改善の貢献度を考えるためにエージェントを機械学習のパラダイムに重ねると、モデルがLLMとエージェントアーキテクチャで、ハイパラがプロンプトになり、データが環境情報(APIレスポンス内容、ドキュメント、コード生成で利用できるライブラリなど)とメモリ(対話履歴や行動履歴)ということになるのでしょうか。 そう考えると、私の中ではモデルに該当する部分はすぐ固定化されてきて、ハイパラやデータの部分で工夫をすることになるのではないかと予想します。 補足ですが、私と似たような考えで、学習のパラダイムに則りプロンプトやツール最適化を行う研究はあります (Zhang, 2024), (Zhou, 2024)。
どうやってエージェントの精度を高めるのか考えてみる
もしエージェントアーキテクチャの貢献度が高くないのなら、既存研究のアーキテクチャを模倣して、環境から得られる情報の質を高めたり、メモリの工夫をしたり、プロンプトの工夫にこだわってもいいのかもしれません。 ただし、プロンプトはLLMに依存するので、モデルのバージョンが変わるたびに調整が必要になります。 また、環境情報をいじりすぎると他のエージェントとの比較が大変になります。ビジネスでは関係ないのでガンガン環境情報の質を高めましょう。
メモリに関しては、WebアプリChatGPTの対話セッションログとは完全に分けて考えて、必要な情報を適切な形式で再利用性を高めて蓄積しましょう。
最後に学習による性能特化は重要です。ソフトウェアエージェントのDevinではo1-previewが出たときに早期アクセスして評価していました。その結果です。
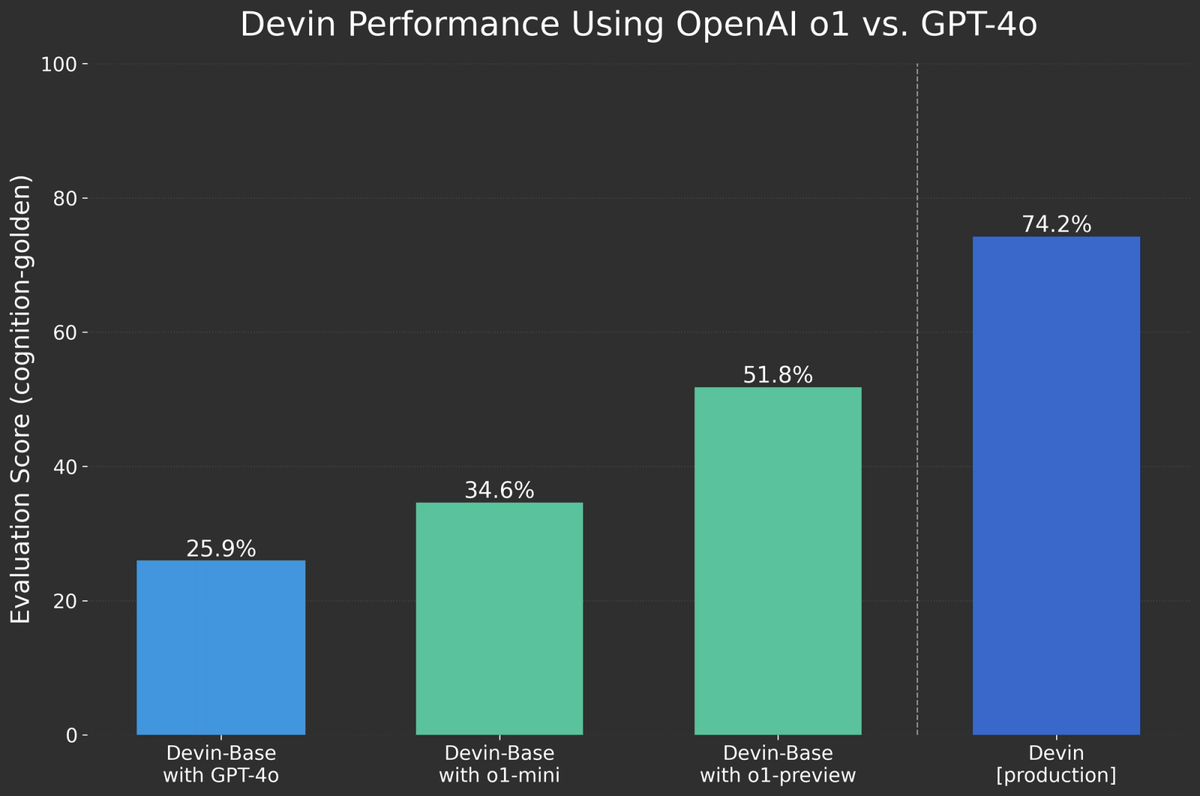
Devinの社内評価ベンチマークで性能がgpt-4oからo1-previewにすることで2倍の51.8%にも上がっています。 そして、モデルを独自データで事後学習した製品用のDevinは更にその上をいく74.2%です。 ここからもモデルを変えることが重要であり、特定の用途で学習をすると精度が格段に向上することが分かります。
更新し続けて良かったこと3選
応用領域や研究アイデアは業務に還元できる
これは非常に大きかったです。 エージェントの議論を社内でするとき、取り組む題材の選定や業務課題を技術に落とし込むときに研究アイデアやテクニックは参考になりました。 あの論文の方法は試してみてもいいな〜と思うことができるようになりました。初手でいきなり筋の悪い一手を打たなくなったと思います。 また、エージェントで取り組むべきかの判断も鋭くなったと思います。どうしてもマーケティング用語から自動化したいならエージェントという方向で考えがちですがそれは間違いです。 エージェントに適した問題設定でないと、無駄な労力をかけるだけです。その目利きは鍛えられたと思います。
会社メンバーの基礎体力の底上げになる
社内育成においてもエージェントの公開資料と合わせて説明することで全員の知識が高まったと思います。 タスク振りも私のイメージしている方法と近い論文をWeeklyの中からささっと選んで共有することで立ち上げもスムーズに思えました。 開発をするときにエンジニアとリサーチャーで知識の差があるとプロダクトで失敗します。相互に意見を合わせて情報交換することで会議や会話が円滑になりました。
イベントや会社外の方との交流が増えた
最初の数ヶ月は認知のために定期的に更新する度に発信をしていました。 ある程度、読者層がついたところで更新の有無をXで通知はしなくなりましたが、それでも勝手に拡散され読者層は一定数いるように思います。 その認知活動の中で、エージェントを取り組む同士やイベントの登壇依頼などが来て外部でも知人が増えました。
最後に
この記事で伝えたいのは、安心してくださいエージェントのアーキテクチャはどれも似ています。 ただし、エージェントの細部にこだわることを忘れてはいけません。
エージェントの応用は今年のトレンドでした。 来年も自社の強みを活かす形でエージェントによる業務効率化を目指しましょう。 どの会社でもできそうなことは別の誰かに任せましょう。
私は正当に作り込んだエージェントであれば、途中でよくあるエージェントの課題(エージェント内部のLLMの課題)にぶつかり、アーキテクチャやプロンプトをそれ以上いじっても精度は対して変わらないラインに達すると考えています。 まずはそこまで作り込めるエージェント開発者になりましょう。 そのためにも作り込めそうなポイントを押さえましょう。 そしてビジネスではエージェントの課題にぶつからない範囲で価値を創出しましょう。 あとはLLMの性能が向上することを期待しましょう。
Weekly AI Agent News!を更新し続け、学び続けるととても視野も広がりましたし、専門性もつきました。 ぜひ、学生の方も今のうちに突き詰めたいことは突き詰めて発信してくださいね!
最後まで読んでいただき、ありがとうございます!
おまけ)最近のAIに関する情報キャッチアップについて思うこと
最新の生成AIの論文は毎日出ていますが、それを全て追っかけると追いかけることが目的になり、企業価値を高めるような仕事なんてできません。 嬉しいことにXでは海外の方含めて国内の方でも論文の要約を発信される方が増えています。その情報を頼るのは一つ有効かも知れません。 ただ嬉しい弊害で、毎朝論文の情報が流れてきて、追いかける情報が増え、自社はまだ全然できていない、社会から遅れていると不安に駆られる方もいるかも知れません。
個人的に木ばかりを見て森を見ないのはナンセンスだと思っています。 エージェントに限らず、生成AIの動向を抽象化して点と点を線で結ぶように解釈することで、驚きが減り冷静に差分を見れます。 特定の文脈で「あることが発見された!」「〜が自動化された!」という論文だけで鵜呑みにするのは危険です。 同じ主張をする論文が多く出てくればそれは信頼できる知見ですが、そうでない場合は一旦頭の片隅に入れておく程度で良いです。
私は生成AIでもエージェントに関する論文に絞り、週単位や月単位でグループ化してまとめているのは、そういう点と点を線で結びやすくするためです。 私は来年もエージェントを本当に業務適応できるか、価値があるのかを取り組む予定なので、AIエージェント周りの動向はWeekly AI Agent News!を通して伝えていきます。
予測の不確実性(Predictive Uncertainty)の原因を整理してみた。
このブログでは、機械学習における不確実性の原因を紹介します。 紹介していく中で、予測の不確実性の定量化に関する研究の背景の一部を自分の言葉で説明していきます。
想定読者:仕事、研究でAI関連に携わる方々のうち、予測の不確実性をふんわりしか知らない人。 このブログではMCMCやキャリブレーションやアンサンブル、分布外検知など、出てきません。
現在、AIの研究では、予測の不確実性を定量化する研究が盛んに取り組まれています。 この研究背景には、XAIの観点で、モデルはいつ自信を持って予測できるのか、予測に自信がない場合の理由は何かを知りたいからだと考えています。 広く言うと、AIシステムの出力結果をもとに意思決定者を支援したいから、だと思っています。

なぜ不確実性の定量化おこなうのか、のお気持ちをもう少し紐解いていくと、 予測の不確実性の生成過程を整理することにつながったため、自分の理解も含めて文字起こししました。
予測の不確実性の定量化の技術動向は、別の資料を参照してください。
- 不確実性とは
- 不確実性を定量化したい背景
- 不確実性の原因を3つの観点で整理
- データ収集時の観点
- AIモデル構築時の観点
- 総合的な観点
- 深層学習における予測の不確実性との繋がり
- コラム
- まとめ
- 参考文献
不確実性とは
「不確実性」は、ある結果に対する知識の欠如を指して使われます。 知識の欠如は、結果に至るまでで、何かしらがわからない、知らない、理解できていないことを伴っている状態とします。 知識の欠如がもとで、結果にばらつきが生まれます。
結果に対する知識の欠如はどうして生まれるのでしょうか。
[Gershon 98]の知識の欠如の原因をもとに考えると、データ収集時でいくつか考えられます。
- 例えば、データに欠損があり、欠損部分が何かわからないから、結果に不確実性が伴う。
- データが少なく、現象の一部分しか見えていないから。
- 複雑な要因をもとにデータが集まり、データの生成過程が不明だから。
- 元から一貫性のない情報からデータ収集され、真実がわからず再現性がないから。
- 収集方法に人間の主観が含まれているから。
と様々です。 さらに、機械学習モデルを構築する中で、アノテーションや、モデル選択を含め、様々な過程で不確実性が生まれます。
つまり、データ収集時でさえ、予測結果に対する不確実性の原因は様々あり、別のシーンでも不確実性の原因は眠っています。 それらが組み合わさって予測の不確実性が定量化されているということです。 このブログでは、不確実性が生まれるタイミングを分け、それぞれでどうして生まれるのかを説明します。
不確実性を定量化したい背景
不確実性が現れる原因は多数あるとわかりました。 では、不確実性を定量化したいモチベーションはどこにあるのでしょうか。 よくある例を題材に説明します。
不確実性は既に定量化されているのでは?
AutoMLの分類タスクでも、ソフトマックス関数を使っていると確信度が出力されるので、それを可視化すればいいじゃないかと思う方もいるかもしれません。
それは正しいですが、確信度の値を持って、人は何をどう意思決定すればいいのでしょうか。 例えば、あるテキストに対して、あるクラスの確信度(0~1)が0.5でした。
確信度0.5と言われると、AIの結果を重視するのを躊躇いますか。
これは、誰がAIの結果をもとに意思決定するのかで変わると思います。 もしあなたがテキストの知識がある程度ある人であった場合、自分と答えが同じか確認するでしょう。 確信度が0.5と出力され、自分と同じ答えであれば、確信度の原因が気にはなりますが意思決定は変えないでしょう。 ただ、自分と違う答えであれば、自分のミスを疑いつつ、AIの結果に疑問を持つと思います。 そして、AIシステムから予測の不確かさの背後にある原因をフィードバックされないと、AIシステムへの信頼が失われていくと思いませんか。
このように確信度だけでは、不確実性の原因を特定することができず、利用者の意思決定の支援に役立てるのが難しいケースがあります。 もちろん、確信度を目安に使うだけで意思決定に影響なく、問題ないケースもあります。リスクの観点がポイントです。
このような背景もあり、不確実性の原因を特定するために、予測の不確実性を分解する形でOOの不確実性の定量化といった個別ケースの不確実性の定量化が取り組まれています。例えば、データの不確実性、モデルの不確実性があります。 このブログでは、OOの不確実性のOOに入る個別ケースを整理します。 中には定量化できていないもの。定量化方法が難しいものがあります。 しかし、大雑把に不確実性の原因がわかれば、後はデータ分析である程度の原因が明らかにでき、AIシステム提供者として利用者にフィードバックができると考えています。 また、不確実性の原因を解決するためにデータを収集するなど、モデル改善の意思決定にもつなげることができます。
似たような話で、ICML2021 Workshop "Uncertainty and Robustness in Deep Learning"のチュートリアルでは、予測モデルがまず間違っていることを知ることが役立つという話がありました。
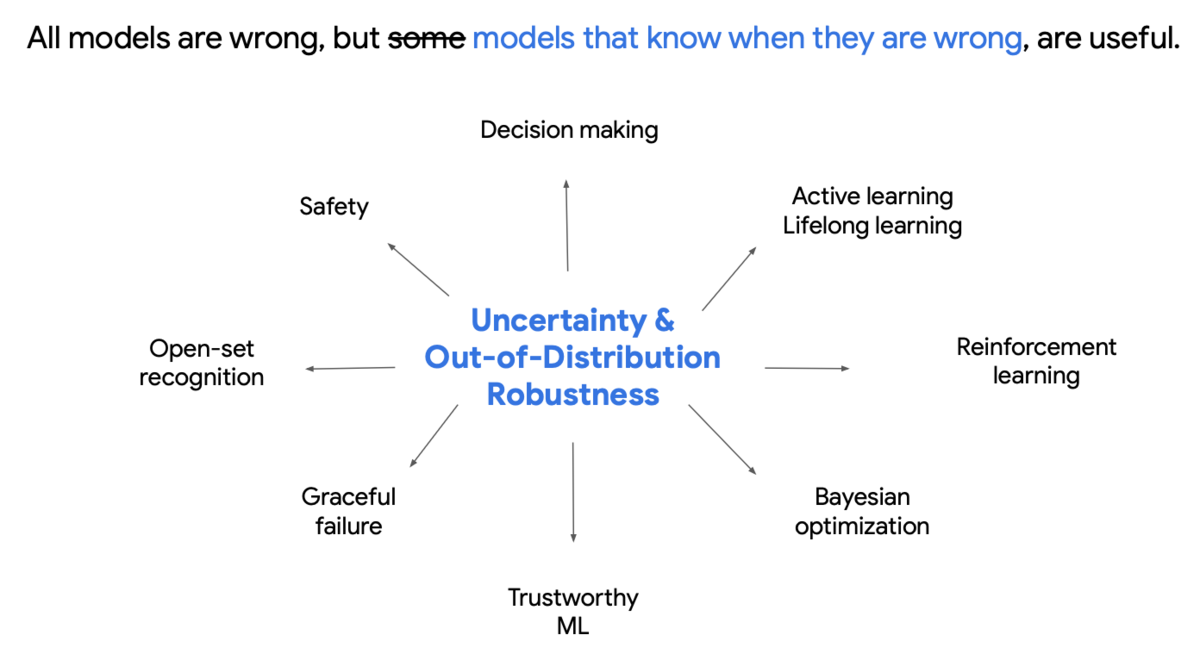
不確実性の原因を3つの観点で整理
ここまで、不確実性の原因を知りたい背景を説明しました。 ここから、本記事のテーマである不確実性の原因について整理していきます。 不確実性の原因を[Thomson 05]や[Skeels 2009]や[Gawlikowski 21] をもとに、3つの観点で順番に説明します。
- データ収集の観点
- AIモデル構築の観点
- 総合的な観点
ここで紹介するものだけが不確実性の原因とは限りません。 気づいていないだけで別の原因は存在するものです。
データ収集時の観点
データ収集は、物理量をセンサーで計測するのか、人の意見・行動をアンケートや利用履歴で集めるのか、 または組合わせるのかで不確実性の原因が変わります。
両方を加味して、[Thomson 05] はデータ収集時の不確実性の原因を大きく3つ(Accuracy、Precisionとtrustworthiness)としています。 [Thomson 05] は、trustworthinessをさらに細かく7種類に分類し、計9種類としました。
ここで出てくる”情報” は、入出力の入力
が得られる前の現象・真実と読み替えて問題ないです。
9つの分類と言葉の定義は以下です。
- 精度/誤差 (Accuracy/ error):データ観測と真実の差
- 正確性 (Precision):測定/推定の正確さ
- 完全性 (Completeness):観測されたデータがどの程度、現象を包括しているか
- 一貫性 (Consistency):情報の要素が一致している度合い
- 系統(Lineage):情報の受け渡し経路による情報の損失
- タイミング (Currency/ timing):情報の発生から収集・加工を経て利用されるまでの期間
- 信憑性 (Credibility):データの信憑性
- 主観性 (Subjectivity):データの構築に人間の解釈や判断がどの程度関与しているか
- 相互関連性 (Interrelatedness):他の情報からの独立性
個別具体的な例を[Thomson 05]から引用して説明します。
| カテゴリ | サブカテゴリ | 例 |
|---|---|---|
| Accuracy | Collection Accuracy(データ収集時の精度) Processing errors(処理エラー) Deception(ごまかし) |
・英語に翻訳された文書には、翻訳エラーが含まれることがある。 ・戦車50台が観測されたが、実際にはダミー戦車であったという報告書がある。 |
| Precision | Precision of collection capability(データ収集能力の精度) | 衛星画像の解像度の問題 |
| Completeness | Composite completeness(構成の完全性) Information completeness(情報の完全性) Incomplete sequence(不完全な系列) |
・悪天候のため、特定の日に現地の衛星画像が得られないことがある。 ・盗聴された音声には、はっきりしない言葉が含まれていることがある。 ・確証のない情報は、不完全であるかもしれません。 |
| Consistency | Multi-INT Conflict Model/observation Consistency |
・複数の情報が衝突することがある。 ・繰り返した観測値が異なる場合がある。 |
| Lineage | Translation(翻訳) Transformation(変換) Interpretation(解釈性) |
・機械翻訳は、言語学者による翻訳よりも不確実性が高い。 ・測定値や信号が変換されている可能性がある。 ・現実のデータ生成過程と、分析者が解釈した報告書とは異なる系譜を持つ 。 |
| Currency/ timing | Temporal gaps (時間的なギャップ) Versioning |
・新しいオブジェクトを示す画像は、そのオブジェクトが最初に出現した時期を示さない。 ・イベントが発生してから、分析者が情報を利用できるようになるまで時間がかかる。 ・報告書には複数のバージョンがあり、時には大きな変更が加えられることがある。 |
| Credibility | Reliability(信頼性) Proximity Appropriateness Motivation (of the source) |
・意図的な偽情報の可能性がある。 ・情報提供者がテーマに関する専門知識を持たない可能性がある。 ・情報が二次的なものである可能性がある。 |
| Subjectivity | Analytic judgment(分析の判断) | ・純粋な事実よりも付加された推測の量が多い。 |
| Interrelatedness | Source independence | ・情報が他の報道された情報(繰り返されるニュース記事など)に由来する可能性が高い。 |
感覚的な部分も多く理解しにくい方向けに、[Thomson 05]が各不確実性の定量化の簡単化した例を紹介しています。
| Category | 確率的な表現 | パラメータの例 | 具体的な定量化 |
|---|---|---|---|
| Accuracy/error | Distribution of measurement error(測定誤差の分布) | source variace | |
| Precision | Measurement device limitations(データ計測装置の制限) | Root mean square deviation | |
| Completeness | Sampling error(サンプリングエラー) | Variance and bias due to sampling error | |
| Consistency | Repeatability across multiple sources(複数のソースにまたがる再現性) | Inter-source variance | |
| Lineage | Change due to transformation stages(データ変換による変化) | Additional variance and/or bias due to channel noise | |
| Currency/ timing | Dependence of accuracy on time of collection(時間的なギャップ) | Dependence on collection time | |
| Credibility | Dependence of accuracy on source (of the source) | Additional variance due to source lack of knowledge | |
| Subjectivity | Distribution of data depends on the analyst | Variance of the analyst | |
| Interrelatedness | Lack of independence | Source Correlation |
数式の説明として、
は情報が与えられたもとで観測値の分散です。
はデータセットとして手元に入手した時のデータの分散です。データセットになるまでに、様々なバイアスが入り、元の分散より大きくなることが多いです。
は別の情報による影響の分散です。
は情報の伝達の中で生まれる分散です。
は完全性を、
は信憑性を表すパラメータです。
各分散が正しく推定できるかは、別問題です。
ここでは、データ収集時の知識の欠如として、情報の信憑性のなさ、計測・入手の正確性の低さ、観測データの網羅性の低さを説明しました。 不確実性の9つの分類の定義は、後の説明でも同じ意味で使います。
AIモデル構築時の観点
データ収集後も人間のAIモデル構築までの選択次第で、不確実性となる知識の欠如を引き起こしていきます。
- データセット作成:データサンプリング(Completeness)、アノテーションミス(Credibility)
- データ前処理:画像のトリミング(Lineage)、文章の正規化(Lineage)
- データセット分割:訓練とテストの分布の不一致(Completeness)
- モデル作成・選択:帰納バイアス(Approximation)、ニューラルネット学習の局所解の違い(Consistency)
- ハイパラ選択:ニューラルネット学習の局所解の違い(Consistency)
アノテーションミスは、サンプルに誤ラベルをつけてしまうことです。
原因は、ワーカーのやる気やドメイン知識量による信頼性の問題なのか、データ収集ミスによるサンプルが識別困難な問題なのかに分かれます。
そもそも、アノテーションの考え方の違いで複数人でラベル付けが変わる場合もあります。
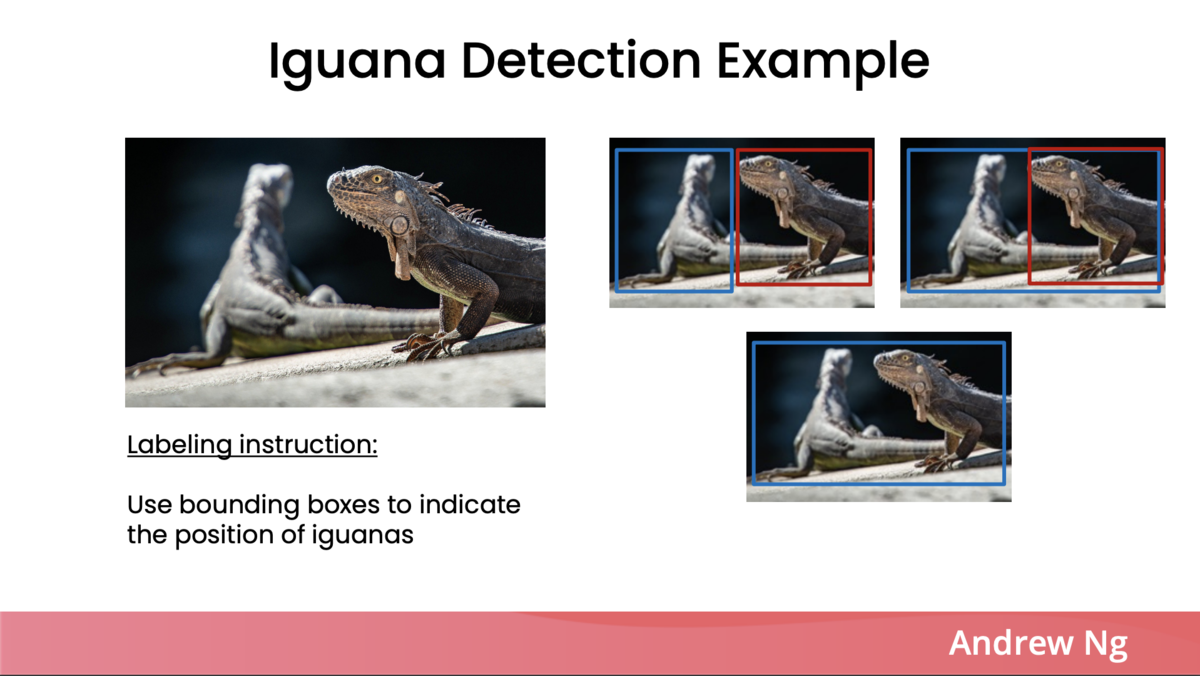
データセット作成において、運用時とのデータの違いを考慮しておらず、訓練時との特徴量の違いから不確実性につながることがあります。 例えば、衛星画像の地物分類をおこなうとき、訓練データには春夏の青茂った森林が多く、期間的に短い秋の紅葉が少なくなる場合があります。

学習時では、ニューラルネットワークのモデルパラメータの初期値依存性による局所解の違いから、予測の不一致が生まれます。
その原因は、サンプル不足や関数近似誤差とも考えられます。

ここでは、AIモデル構築時の不確実性の原因として、データセットの現象の網羅性の低さ、アノテーションの質の低さ、モデルの近似誤差を説明しました。
総合的な観点
不確実性は、様々な箇所で発生することがわかりました。
これらを[Skeels 09] がまとめた結果、以下に分類され、レベルごとに不確実性は伝達されていきます。
レベル1ではデータ収集、レベル2ではデータ整形、レベル3ではAIモデル構築の不確実性の原因に該当し、全ての階層で不一致(inconsistency)と信憑性(Credibility)の原因がつきまといます。
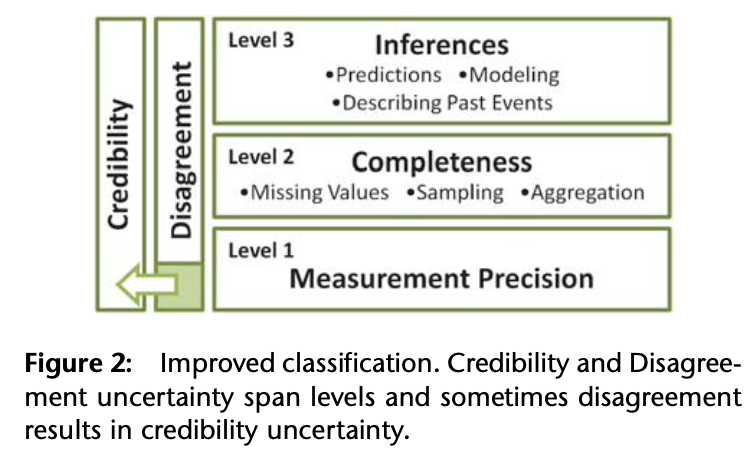
- Approximation(近似)
図に書かれていませんが、全ての階層に横断する不確実性の原因です。 科学やその他の領域では、近似が必要な場合が多く、近似が不確実性につながります。 この不確実性は、測定される現象が持つランダムな変動によるもの、モデル化するために必要な単純化された仮定によるもの、センサーの計測機器の限界によるものがあります。また、母集団全体ではなく、サンプリングする場合にも近似が発生します。
- Disagreement or inconsistency(不一致)
専門家同士の意見の不一致は、不確実性を示していると考えています。 測定精度の不一致は、同じものを複数回または異なるセンサーによって測定され、測定値が同じでない場合に発生します(系統誤差と偶然誤差)。 完全性の不一致は、データセットは部分的に重複しているが同一でない場合に予測で不一致が生じます。 推論の不一致は、同じデータから2つ(またはそれ以上)の異なる結論が導き出されることによって不一致が生じます。 これは、2人(またはそれ以上)の専門家がデータセットを見て異なる結論に達した場合や、2つの異なる数理モデルをデータセットに適用して推論を行った場合などが考えられます。
- Credibility(信憑性)
不確実性の一種である信憑性は、データの出所に起因することもあります。 信頼できない情報源から得たデータは、信頼できる情報源から得たデータよりも不確実性が高いとみなされます。 信頼できる情報源とみなされない理由は、データ収集方法、またはデータの作成者の偏見や利益相反を取り巻く懸念に関連する可能性があります。 この不確実性は簡単に測定することはできません。 他のデータと矛盾するデータを作成する情報源、過去に信頼できないデータを作成した情報源、または何らかの理由で疑わしい情報源は、不確実性につながります。 しかし、何をもって信頼できる情報源とするかは、個人によって判断が異なる場合があります。
基準としては、過去の行動の関連性があげられています。 人からの情報源は、過去の行動や関連性から信頼できるとみなされることがあります。 専門医からの情報は、専門医の知識と専門性を信頼しているため、一般医からの情報よりも不確実性が低いかもしれません。
不確実性が伝達される例
これらの総合的な原因も理解した上で、不確実性の伝達の様子を[Skeels 09] の例を訳して説明します。
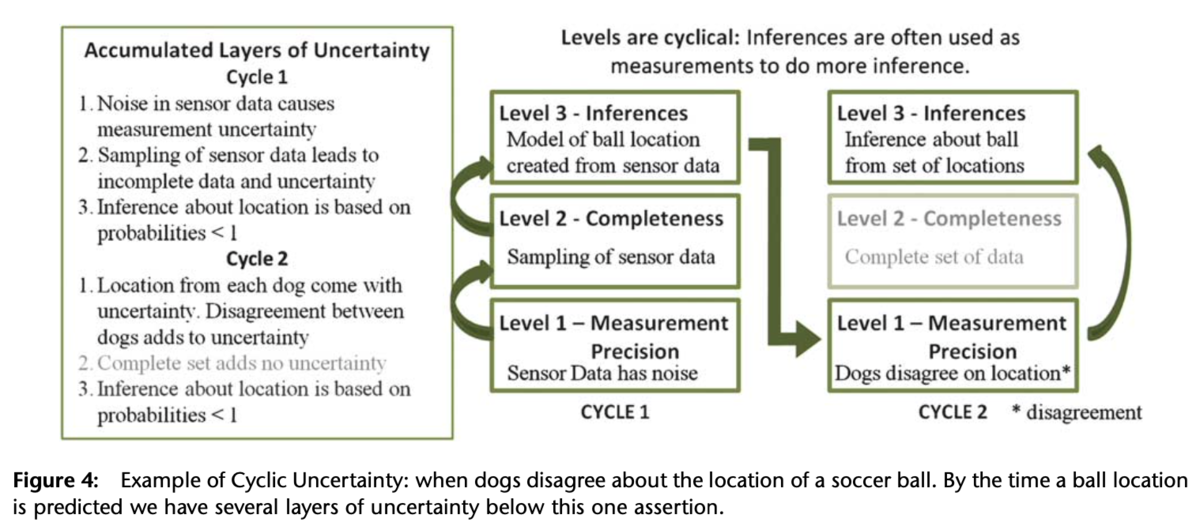
ロボット犬がサッカーをするプロジェクトを例に、不確実性のレベルの違いとその相互作用について説明します。
犬がサッカーをするとき、問題の1つはサッカーボールの位置を特定することです。
各犬はボールの位置を把握するために複数のセンサーを持っています。
個々の犬のレベルでは、センサーデータのノイズにより計測の不確実性があります。
この計測の不確実性に加えて、理論的には連続であるが、実際にはサンプリングされているため、データの不完全性による不確実性も存在します。
また、センサデータをボールの位置に変換するモデルが近似であるため、不確実な測定値の不完全なサンプルをボールの位置の推定に使用する場合、推論レベルでも不確実性が存在します。
これは、1頭の犬であれば、ボール位置の不一致に基づく不確実性は存在しません。
しかしチームであるため、複数の犬によるボール推定位置の集合ができ、ボールの位置の確率を特定するための推論がおこなわれます。
結果的に、ボールがその時どこにあるかは、何重もの不確実性が混ざっています。
推論は他の推論の上におこなわれ、その推論は不完全なデータの集合の上でおこなわれています。
深層学習における予測の不確実性との繋がり
ここまで、不確実性の原因をデータ収集からAIモデル構築までの間で、分類しつつ説明してきました。 深層学習における予測の不確実性の定量化では、今まで上げた不確実性の何を定量化しているのか最後にまとめます。
[Gawlikowski 2021]のサーベイ論文からは、大きく2つの不確実性が定量化されています。 予測の不確実性において、データに内在する問題なのか、データの不足による問題なのかを区別することです。
- データに内在する問題(データの不確実性)
データ収集の計測機器の制限の可能性(Precision)、データノイズの可能性(Accuracy)、類似データとの混同の可能性( Information completeness)、アノテーションミスの可能性(Credibility)であり、これらを区別せず、データの不確実性として定量化しています。
- データ不足による問題(モデルの不確実性)
データ収集方法の欠陥による情報不足の可能性(Composite completeness)データ選択時の情報欠落の可能性(Completeness)、帰納バイアスによる分類境界の変動の可能性(Approximation)があり、これらを区別せず、モデルの不確実性として定量化しています。
情報の信頼性(信憑性)に関わる不確実性の定量化は、まだ研究レベルであり、取り組みが少ない認識です。
情報の信頼性に最も近い文脈だと、ワーカーのアノテーションの品質を情報の信頼性と捉えるのが近いかもしれません。 ただ、例えば、推論時に予測の不確実性が低く、その理由が ”推論データに最も近いデータをアノテーションしたワーカーは品質が高く信頼できるから。”と出力する説明は見たことはありません。
コラム
本筋とは関係ないですが、不確実性の原因をより広げた考え方と今日出てきた話と関連する概念を紹介します。
意思決定までの不確実性の伝達
今までの議論をより俯瞰的に見ると、不確実性は可視化と意思決定にまで広がっています[Kamal 2021] 。
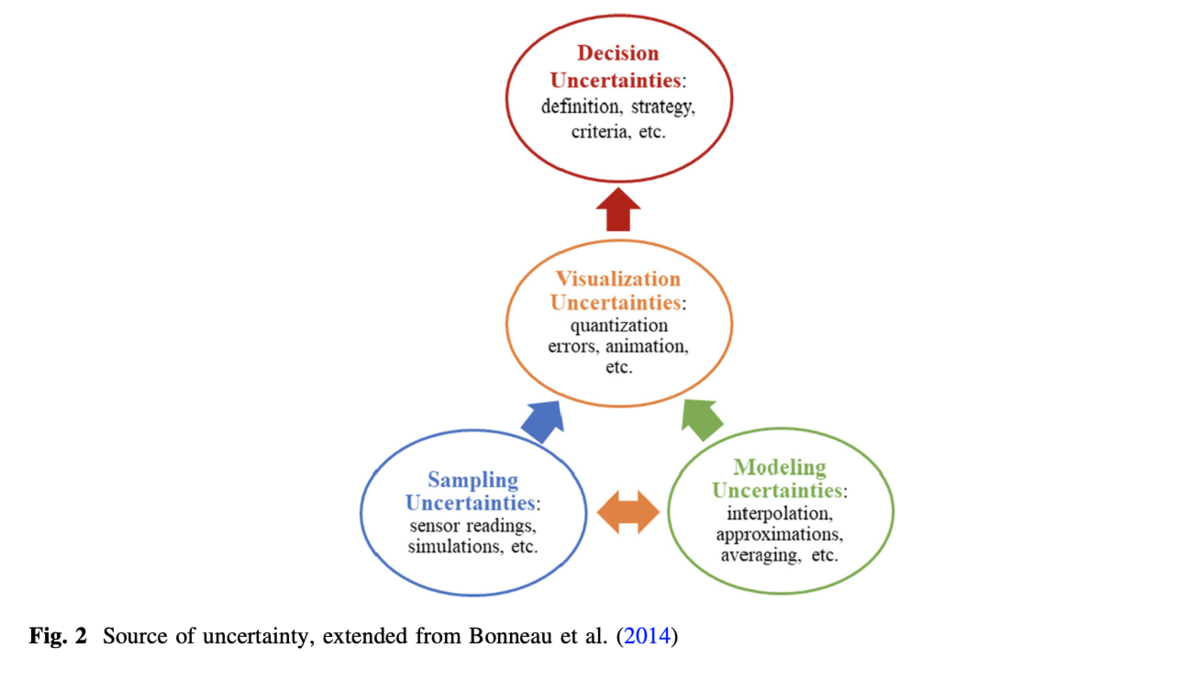
Visualization uncertainty
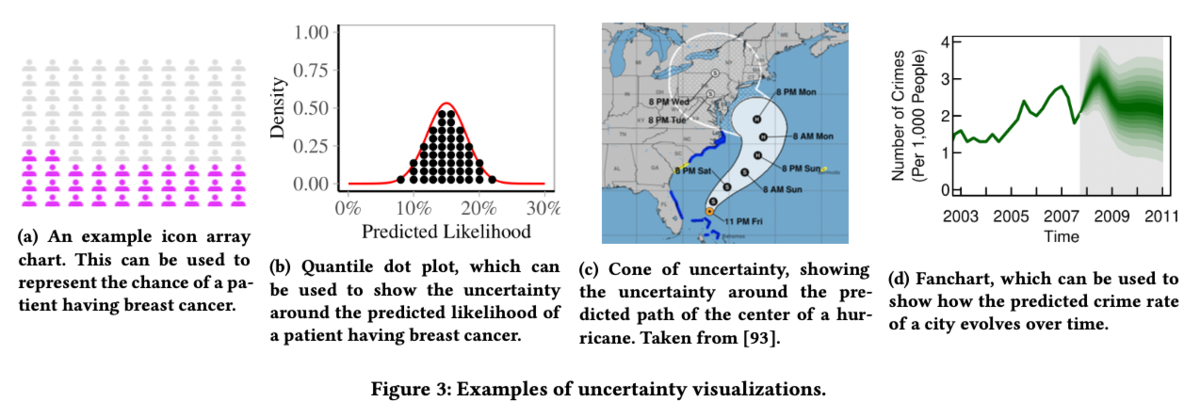
可視化プロセスそのものが不確実性をもたらします。 例えば、データが多すぎると、可視化が乱雑になり、情報の整理ができず、人の知識の欠如(不確実性)が増大する可能性があります。
不確実性の可視化は、95%信頼区間に色つけるか、エラーバーか、テキストをカラー強調するのか、ぼかすか、%表記するのか様々です。 ユーザーの個々の能力や理解度によって、可視化される不確実性の種類が異なる可能性があります。 例えば、分数で不確実性を表現すると、分母を過小評価することがあります(比率バイアス)。例えば、9/11は10/13より小さいと考える人がいます。
Decision uncertainty
まだ説明できるほどわかっていません。
不確実性の意識(Awareness)
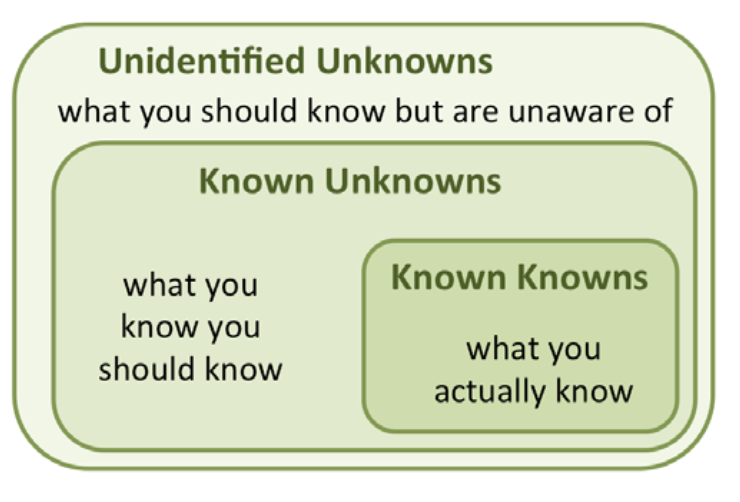
最後にデータ分布外検知に関連する部分で完全性と近い概念の不確実性の意識(Awareness)があります[Sacha 16]。
手元のデータ情報から、自分が知っている情報(known knowns)と、存在は知っているが調べないとわからない情報(known unknowns)、自分が知らない情報(unidentified unknowns)を区別する概念です。
まとめ
- 不確実性の定量化の研究が盛んな動機は、AIシステムの出力結果をもとに意思決定する者を支援したいからだと考えています。
- 不確実性の定量化を意思決定者に役立てるためには、不確実性の原因ごとに定量化する必要があることを説明しました。
- 不確実性の原因をデータ収集時の観点、予測モデル構築時の観点、総合的な観点で整理しました。
- 総合的な観点では、不確実性の原因は段階的に伝達されていき、最後は予測の不確実性として表現されることを例を用いて説明しました。
- 深層学習では、不確実性の原因をデータに内在する問題、データ不足による問題と大きく抽象化し、定量化していることを説明しました。
- 抽象化された不確実性から個別の原因を特定するには、不確実性の高いサンプルをより分析することで明らかになると思っています。
超個人的には、不確実性の定量化が、人とAIが協調する際の接着剤になればいいなと思っています。 人は、AIを過度/過小に信頼せず、AIも予測の不確実性を適切に定量化することで相互にバランスを取り、人とAIが適材適所する協調システムが実現できればと考えています。
興味が出た方は、私のGithubに不確実性に関する論文をまとめてあるので覗いてみてください。
参考文献
- [Bhatt 21] Bhatt, Umang, et al. "Uncertainty as a form of transparency: Measuring, communicating, and using uncertainty." Proceedings of the 2021 AAAI/ACM Conference on AI, Ethics, and Society. 2021.
- [Gawlikowski 21] Gawlikowski, Jakob, et al. "A survey of uncertainty in deep neural networks." arXiv preprint arXiv:2107.03342 (2021).
- [Gershon 98] Gershon, N.D., Visualization of an imperfect world. Computer Graphics and Applications, 1998. 18(4): p. 43- 45.
- [Kamal 21] Kamal, A., Dhakal, P., Javaid, A.Y. et al. Recent advances and challenges in uncertainty visualization: a survey. J Vis 24, 861–890 (2021).
- [Sacha 16] Sacha D, Senaratne H, Kwon BC, Ellis G, Keim DA. The Role of Uncertainty, Awareness, and Trust in Visual Analytics. IEEE Transactions on Visualization and Computer Graphics. 2016 Jan;22(1):240-249.
- [Skeels 09] Skeels, Meredith, et al. “Revealing Uncertainty for Information Visualization.” Information Visualization, vol. 9, no. 1, Jan. 2010, pp. 70–81.
- [Thomson 05] Thomson, Judi, et al. "A typology for visualizing uncertainty." Visualization and Data Analysis 2005. Vol. 5669. International Society for Optics and Photonics, 2005.
- [Qin 22] Qin, R.; Liu, T. A Review of Landcover Classification with Very-High Resolution Remotely Sensed Optical Images—Analysis Unit, Model Scalability and Transferability. Remote Sens. 2022, 14, 646.
